

| LKE:从简单开始 | LKE-Enterprise:从容地扩大规模 |
|---|---|
| 免费控制平面(高可用 HA 选项仅需 60 美元/集群) | 专属高可用控制平面,每月固定费用 300 美元 |
| 多达 250 个节点 | 多达 500 个节点 |
| Calico CNI | Cilium CNI(性能更出色) |
| 标准 NodeBalancers(负载均衡器) | 高级 NodeBalancers、VPC 隔离及增强的安全性 |
| 使用 Akamai 持续扩容的 GPU 节点集群 | 提供相同的 GPU 节点池,并支持扩展至最多 5,000 个 GPU 的集群 |
概览
运行 Kubernetes,而非控制平面。
部署、管理并弹性扩展容器化与 AI 工作负载,无需担心控制平面可用性、节点故障或版本升级问题。LKE 是一项通过 CNCF 认证、可用于生产环境的 Kubernetes 服务,运行于 Akamai Cloud。它在单个集群中提供 GPU 节点池以及预集成的开源 AI 技术栈。
专为需要可移植性和控制力的开发者打造
工作原理
为您的团队选择合适的托管 Kubernetes 服务级别
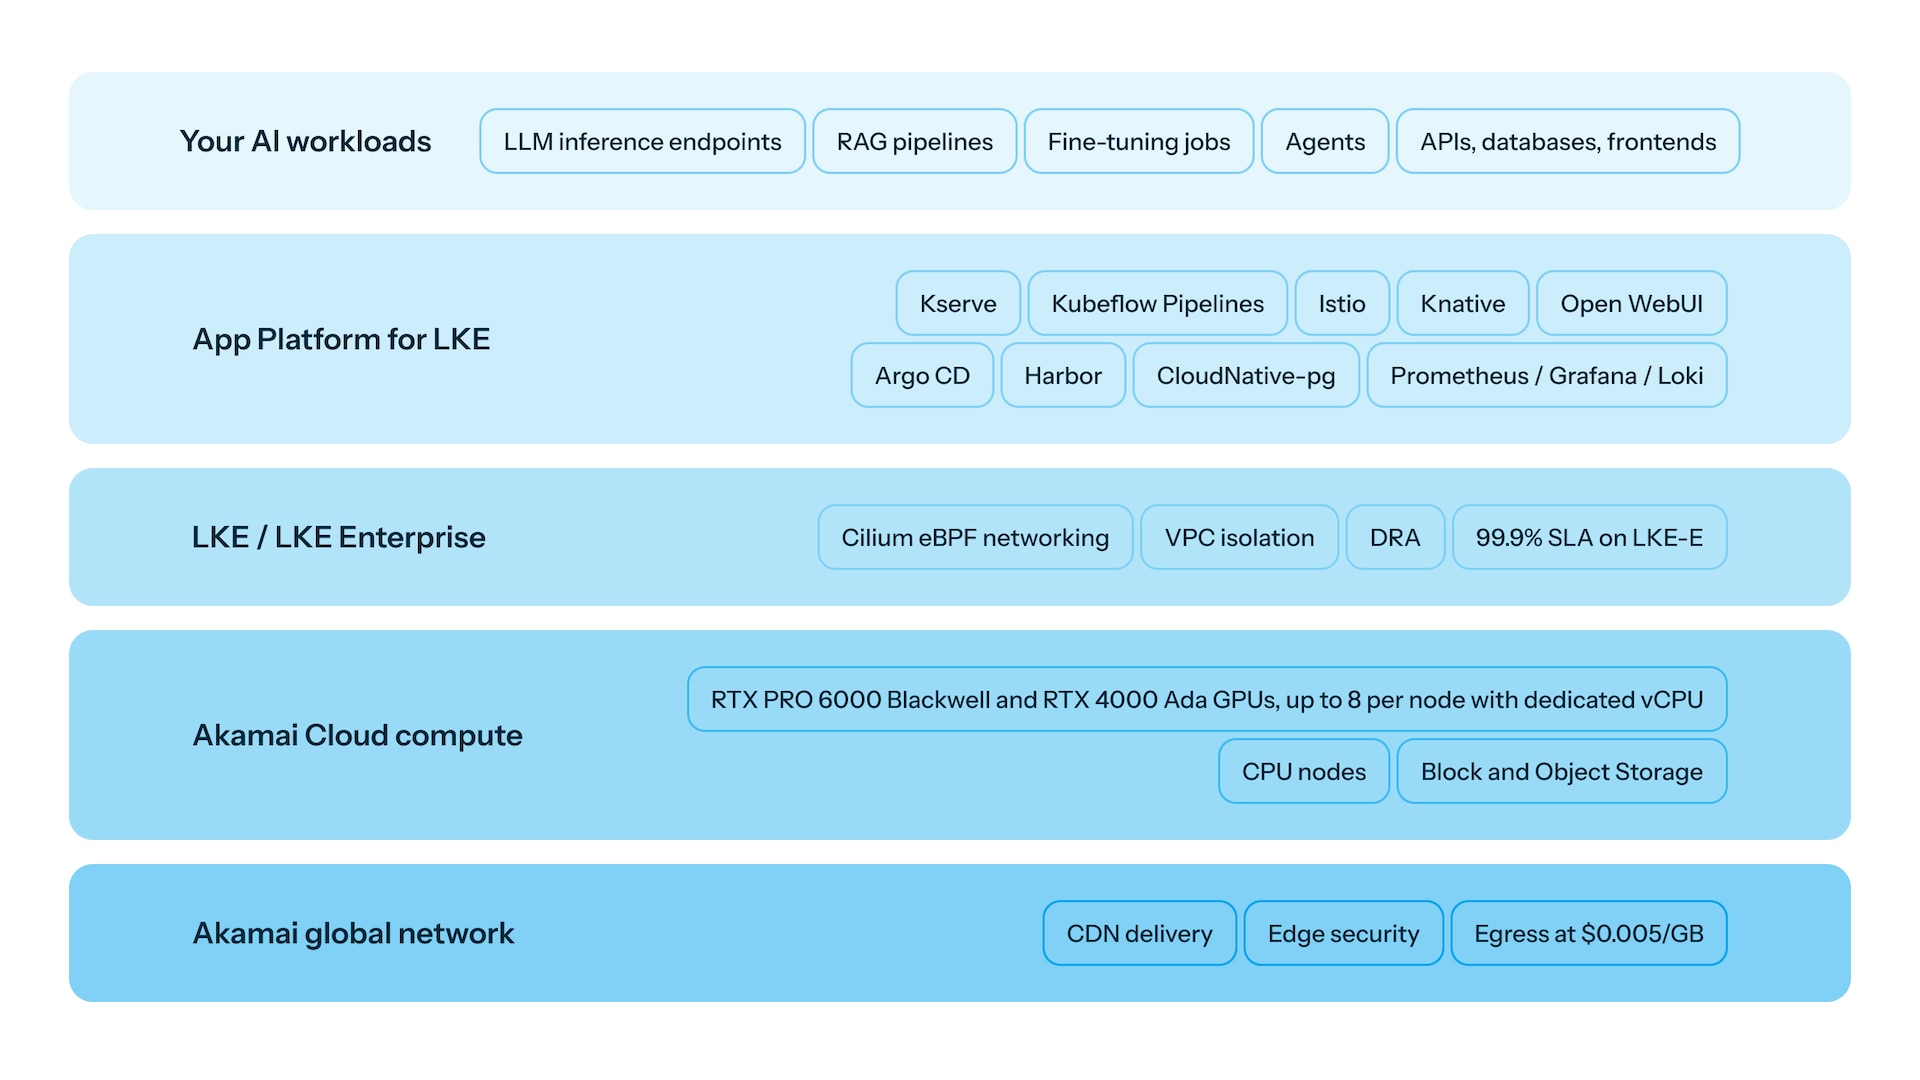
一个集群,五层架构
基于 Akamai 全球网络构建,提供 CDN 交付、边缘安全以及 0.005 美元/GB 的数据出口费用。添加 GPU 和 CPU 计算资源,以及 Block Storage 和 Object Storage。在上层运行 LKE 或 LKE Enterprise,然后使用 App Platform 构建 AI 技术栈,最后运行您的工作负载。
AI 工作负载
LKE 上的 AI 工作负载
在与其他应用相同的托管 Kubernetes 平台上运行推理、RAG 流程、微调和 AI Agent
无缝迁移、预集成工具、零摩擦
赋能工程师,加速开发者效率
* 请参阅促销兑换规则和条件
功能
LKE 托管型 Kubernetes 核心功能特性
借助内置安全性、自动化扩缩容以及跨分布式云环境的高可用性,简化 Kubernetes 运维管理;同时具备出色的灵活性,全面支持 AI 与推理工作负载。
特性
- 使用 Cloud Manager、CLI 或 API 在数分钟内即可启动生产级的集群
- 一键添加 LKE 的 App Platform,获得预集成的 CNCF 技术栈:KServe,Kubeflow,Istio,Knative
- 通过自动化、零停机的版本更新,确保集群始终与最新的 Kubernetes 版本保持同步
- 系统会根据工作负载的变化自动增加或移除节点,同时为每个节点池提供了内置的数据加密功能
- 以每 GB 0.005 美元的出口流量费用传输数据,并可在同一平台上使用 Akamai CDN。
- 从开发/测试到生产级、多团队及 AI 工作负载,全面满足各种场景需求
- 您可以在需要时增加 NodeBalancers,也可以进行升级以获得高级路由和更高的吞吐量
- 在 LKE Enterprise 上实现 VPC 隔离和增强型网络安全,满足合规性和多租户需求
- 选择您的 CNI:LKE 使用 Calico,简化网络管理;LKE Enterprise 使用 Cilium,提升性能和可观测性

客户案例


常见问题
常见问题
是的。您可以使用相同的 Kubernetes 版本和清单来迁移现有集群。
LKE Enterprise 为控制平面和工作节点提供 99.9% 的 SLA。LKE 提供尽力而为的正常运行时间,并提供标准的 Akamai 服务支持。
是的。您的费用仅限于您实际部署的资源(节点、存储、负载均衡器)。但如果您选择了 HA 控制平面,则会产生相关的费用。
LKE 使用 Calico 实现 Pod 网络。LKE Enterprise 使用 Cilium,提供基于 eBPF 的高性能和可观测性,并支持 VPC 隔离。网络策略在两个层级中均可使用。
LKE 与 LKE Enterprise 紧跟 Kubernetes 上游社区演进,但采用独立的发布计划,因此各层级所支持的版本可能有所不同。请参阅文档获取最新列表。两种层级均包含自动化、微停机的平滑升级服务。
GPU 节点池采用 NVIDIA RTX PRO™ 6000 Blackwell Server Edition® 与 RTX 4000 Ada,单节点最高支持 8 块 GPU 并配备专属 vCPU 内核。LKE 的 App Platform 增添了预集成的开源 AI 技术栈,官方已发布的指南涵盖 LLM 推理、RAG 管道以及模型微调。
是的。LKE 支持具备可扩展性的 AI 推理工作负载。它具备原生 GPU 支持、GPU 感知型自动扩缩容,以及企业级网络和存储能力。由于 LKE 符合 CNCF AI Conformant 标准,工作负载无需承担超大规模云服务提供商带来的复杂性和成本,即可满足业界认可的标准。
CNCF 认证意味着您的 Kubernetes 环境符合严格且与供应商无关的可靠性、兼容性和互操作性标准。实际上,这意味着无论您是在 LKE 上运行,还是在云原生生态系统中的其他平台上运行,您的工作负载、工具和 API 都能保持一致的运行方式。对于 AI 团队而言,CNCF AI Conformance 意味着 LKE 已针对现代 AI 部署所需的工作负载模式和基础设施要求进行验证。您可以获得经过验证的标准所带来的信心,同时避免供应商锁定。
探索在 Kubernetes 上部署 AI 的相关资源
了解您是否可以申请高达 5,000 美元的云服务抵扣额度
我们将随时为您提供大规模部署、迁移、应用程序优化、架构评估、安全和可靠性审计等方面的帮助。如需获取支持或者遇到了帐户相关问题,请访问我们的支持页面。

