Michael Sparkman
Michael SparkmanはAkamaiのData Scientistです。災害・救援プロジェクト、不正検知およびセキュリティ分析の分野で6年の経験を有し、特にボットによる自動化を専門としています。Akamaiでは、新たな自動化型脅威の研究に取り組むとともに、お客様のセキュリティポスチャを強固に保つための支援を行っています。
自律型AIブラウザーエージェントは、スパースで、非常に効率的なふるまいテレメトリによって動作する、新たな種類のWebトラフィックを生み出しています。
リクエストの98%以上では、マウスの動きがほとんど、あるいはまったく記録されないため、従来のボット検知モデルでは、これらのエージェントを適切に評価できません。
Akamaiは、マウスのテレメトリを言語のトークンのように扱い、短いイベントシーケンスを分析するMasked Autoencoder Transformerモデルの概念実証(PoC)を開発しました。
さらに、Transformerの埋め込み表現を用いて学習した軽量な分類器によって、クラス間のデータ数に極端な偏りがある状況でも、スパースな人間のセッションとエージェント型自動化を高い精度で識別できることを確認しました。
Webサイトを、これまでとは違うタイプの訪問者が閲覧しています。私たちが想定するようなマウス操作をしない訪問者です。この1年ほどの間に、単に質問に答えるだけではないAIツールが登場しました。ブラウザーを操作して、実際に行動するのです。
PerplexityのComet、OpenAIのAtlas、AnthropicのClaude in Chromeなどのツールは、自然言語による指示(たとえば「300ドル未満のボストン行きの航空券を探して、予約して」)を受け取ると、そのタスクを完了するために、Webを自律的に操作することができます。マウスを操作している人間はいません。ページを読んでいる人間もいません。そこに「いる」のはAIエージェントだけです。AIエージェントが、人間に代わってWebサイト上でクリックや文字入力を行いながら、タスクを進めていくのです。
この自動化は「コントロールブラウザー」モードとも呼ばれており、従来のボットトラフィックにも人間によるトラフィックにも当てはまらない、新しい種類のWebトラフィックを生み出しています。Akamaiでは、このトラフィックがテレメトリレベルでどのように見えるのか、そしてそれを識別できるのかを理解したいと考えました。
このブログ記事で紹介するのは、全2回シリーズの第1回にあたる概念実証(PoC)研究です。今後は、この研究をさらに発展させ、より堅牢で実運用に適した機能として実装することを目指しています。
注:OpenAIは、当社の研究完了後にAtlasの提供終了を発表しました。この変更にもかかわらず、本研究は、AIエージェントがブラウザーを操作し、自律的に操作を進める仕組みについて、貴重な知見を提供しています。
長年にわたり、Webセキュリティでは、ボット検知を基本的に二者択一のモデルで捉えてきました。つまり、リクエストは人間によるものか、ボットによるものかのどちらかです。そしてボットには、大きく2つのタイプがあります。1つ目は、人間になりすますことすらない、単純で高度な技術を使わないクローラーです。2つ目は、シンセティックなマウス操作を生成し、操作のタイミングに変化をつけるなど、あらゆる手段を使って人間になりすます、高度な模倣型ボットです。
自動化モードのエージェントは、このどちらのボットカテゴリーにも当てはまりません。誰かをだまそうとしているわけではなく、単に、人間とは異なる方法でブラウザーを操作しているのです。エージェントはWebページを開くと、目的の場所へ直接移動します。
人間のように、ページを読みながらカーソルを動かすことはありません。
クリックする前に、ボタンの上でカーソルをホバーさせることもありません。
ページを探索するためにスクロールすることもありません。
正確にクリックし、効率よく入力し、次の操作へ進みます。
その結果として現れるのが、スパースで機械的かつ効率的なふるまい特性です。そして、既存の検知ツールは、このようなタイプのトラフィックを検出するために作られていないため、検知上の課題が生じます。
Akamai Bot Manager Premierは、豊富なふるまいテレメトリを収集します。具体的には、計測対象となっているWebページから送信される、マウスイベント(移動、クリック、スクロール)のシーケンスです。当社の既存のふるまいモデルは、これらのシーケンスを分析し、人間とボットを識別するもので、この用途では十分に機能します。ただし、重要な前提条件があります。有意義な比較を行うには、1つのシーケンスに十分な数のイベントが含まれていなければなりません。
CometとAtlasを自動化モードで動作させて収集した数百件のセッションにこれらのモデルを適用した結果、次のことがわかりました。
63.2%のエージェント型自動投稿リクエストには、マウスイベントが1件も含まれていなかった
35.8%は、イベント数が最低閾値を下回っていた
評価に十分なマウス移動イベントが含まれていたリクエストは、わずか1.0%だった
既存のマウス移動モデルが、エージェント型自動化による全リクエストのうち、疑わしいものとして検知したのは1%未満でした。モデルが機能していなかったわけではありません。実行さえされなかったのです。自動化モードのエージェントは、基本的にマウスを使っていないため、マウステレメトリをほとんど生成しません。エージェントは、プログラムからWebページを操作します。テレメトリがスパースなのは、エージェントが検知を回避しようとしているからではありません。人間による操作であれば生じるようなインタラクションの痕跡を、そもそも生成していないからです。
「評価された」ものと「評価可能だった」ものとの間にあるギャップこそが、解決すべき核心的な問題でした。
スパースなテレメトリでも機能するモデルを構築するために、問題の捉え方そのものを変える必要がありました。
マウスイベントを、単語のように考えてみてください。1つの単語だけでは、文の書き手についてほとんど知ることはできません。しかし、単語のパターン、単語のリズム、相対的な出現頻度、単語間の間などには、多くの情報が含まれています。エージェントが書いた文章は、無駄がなく、意図が明確です。話がそれることも、後戻りすることも、無駄な言葉を挟むこともありません。一方、人間が書いた文章は、より複雑で豊かです。
このアナロジーが、私たちのモデル化アプローチの基礎となりました。そして、このアナロジーは単なる比喩ではなく、モデルのアーキテクチャそのものにも反映されています。これまで大規模言語モデル(LLM)のファインチューニングに取り組んできた経験から、直接的な類似性が示唆されました。Transformerが文章中の語彙トークン同士の関係をモデル化するために用いるのと同じアテンション機構を、ふるまいシーケンス内のマウスイベント同士の関係をモデル化するためにも適用できるかもしれないということです。
TransformerのKey/Queryアテンションブロックでは、各トークンが他のすべてのトークンにアテンションを向けることができます。これによりモデルは、トークン同士の距離に関係なく、あるトークンの意味を理解するうえでどのトークンが重要なのかを学習できます。これをマウスのテレメトリに適用することで、モデルは少数のイベント間に存在する関係を学習できます。そして私たちは、このようなTransformerモデルが、シーケンスが短い場合でも、こうした関係を効果的に利用する方法を学習できることを確認しました。
つまり、評価のために長大なイベントシーケンスを必要とするモデルを構築するのではなく、短いシーケンスが何を意味するのかを理解できるモデルを学習させました。その目的は、エージェントが用いる、スパースで意図の明確なマウスの「語彙」と、人間の語彙とを区別することです。
以下のアーキテクチャは、PoC向けの設計です。初期調査であることを踏まえ、学習データの規模とモデルの規模は、意図的に控えめに設定しています。本番環境に導入する場合には、より大規模なモデルと、より包括的なラベル付きデータの収集が必要になるでしょう。
セッションをエージェントによるものか人間によるものかに分類する前に、まずモデルに、通常のマウス操作に見られる基本的な構造を学習させる必要がありました。
そこで私たちは、自己教師あり学習を用いる自然言語処理アーキテクチャであるMasked Autoencoder Transformerを、ふるまいテレメトリ向けに適応しました。このモデルは、実際のBot Manager Premierのテレメトリから得られた、約350万件のラベルなしマウスイベントシーケンスを使って学習しました。学習中は、各シーケンスのイベントの35%をランダムにマスクし、モデルが周囲のコンテキストから元のイベントを再構成するようにしました。そのため、人手によるラベル付けは一切必要ありませんでした。
軽量アーキテクチャ
このアーキテクチャは、意図的に軽量に設計されています。
44,000パラメーター
Transformer 3層
4つのアテンションヘッド
シーケンスごとに固定された64次元の埋め込み表現
位置ではなく時間をエンコードする
重要な設計上の選択の一つは、標準的な位置エンコーディング(1番目のイベント、2番目のイベントなど)を、累積タイムスタンプに置き換えたことです。 経過時間に正弦波エンコードを適用すると、これはフーリエ分解のように機能し、それぞれのタイムスタンプを複数の周波数に同時に投影します。
高周波成分は、短時間に連続して発生するイベント間の微細な時間差を捉える
低周波成分は、セッション全体のリズムを捉える
これにより、モデルはタイミングのパターンを重要な特徴量として学習することになります。AIエージェントに典型的に見られる、長く不規則な間隔(クリックとクリックの間が数秒空くこともある)も、単なるシーケンス長のアーティファクトではなく、意味のあるシグナルとして扱えるようになります。
64次元のふるまいの埋め込み表現を生成する事前学習済みTransformerを用いて、エージェント型のふるまいを識別する小規模な教師あり分類器を学習させました。具体的には、Comet、Atlas、Claude in Chromeを、Bot Manager Premierが導入された実際の顧客Webサイト上で実行し、2,190件のラベル付きエージェントふるまいシーケンスを収集しました。
チームは以下のような標準化されたプロンプトを用いてこれらのツールを操作しました。
「商品ページに移動して、商品Xをカートに追加して」
「ログインページを見つけて」
「カテゴリーYの商品を比較して」
その結果得られたBot Manager Premierのセッションデータを収集しました。人間のベースラインデータは、同じ顧客Webサイトから取得しました。
これらのデータを組み合わせると、大きなクラス不均衡が生じました。エージェント型1件に対して、人間によるセッションが約85件存在する割合です。この不均衡には、クラスごとに重み付けした損失関数を使用するとともに、少数クラスであるエージェント型データに対して大規模なデータ拡張を行うことで対処しました。データ拡張には、ガウスノイズ、特徴量のランダムなドロップアウト、時間軸のランダムなスケーリングを用いました。
第2段階の分類器には、64次元の埋め込みを入力とする2つの隠れ層(64 → 32ユニット)を持つ、浅い多層パーセプトロン(MLP)を採用しました。このモデルを、One-Class Support Vector Machine(SVM)、Isolation Forest、Variational Autoencoder(VAE)を用いたアプローチと比較しました(表参照)。教師あり学習によるMLPは、他のすべての手法を大幅に上回る性能を示しました。これには、未知のデータに対してより高い汎化性能が期待されることの多い、One-Class分類型の手法も含まれます。
| アプローチ | ROC-AUC | PR-AUC | 注記 |
|---|---|---|---|
| One-Class SVM | 0.797 | 0.044 | 人間のデータのみを用いて学習 |
| Isolation Forest | 0.833 | 0.038 | 実用的な閾値では再現率がほぼゼロ |
| VAE + エネルギーベース損失 | 0.882 | 0.410 | 有望だが、チューニングが難しい |
| 浅いMLP(最終モデル) | 0.981 | 0.661 | 選択されたアプローチ |
第2段階の分類モデルの比較では、浅いMLPが優れた性能を示したことを実証
重要な知見
エージェント型のふるまいは、単純に「人間の分布の外側」に存在するわけではありません。たとえば、1回だけ直接クリックして離脱するユーザーのような、スパースな人間のセッションとは一部重複しています。そのため、エージェントを検知するには、単に外れ値を検出するのではなく、人間とエージェントを区別する識別境界を学習する必要があります。
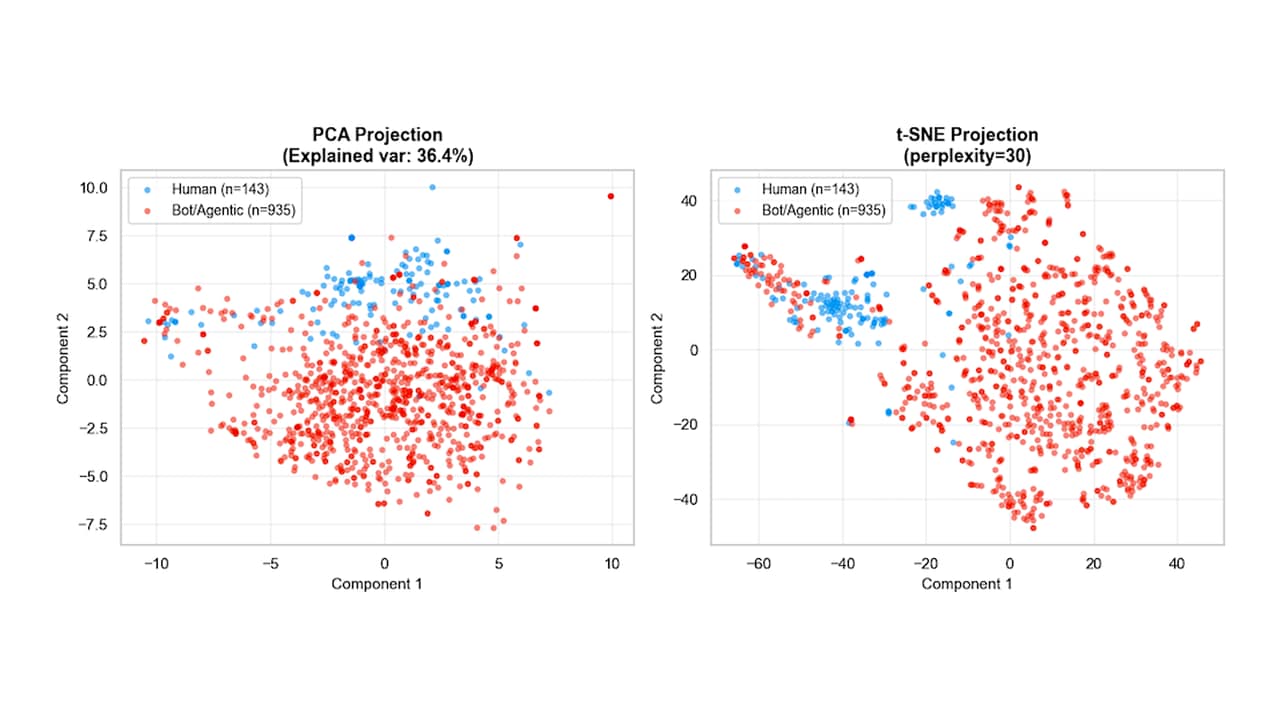
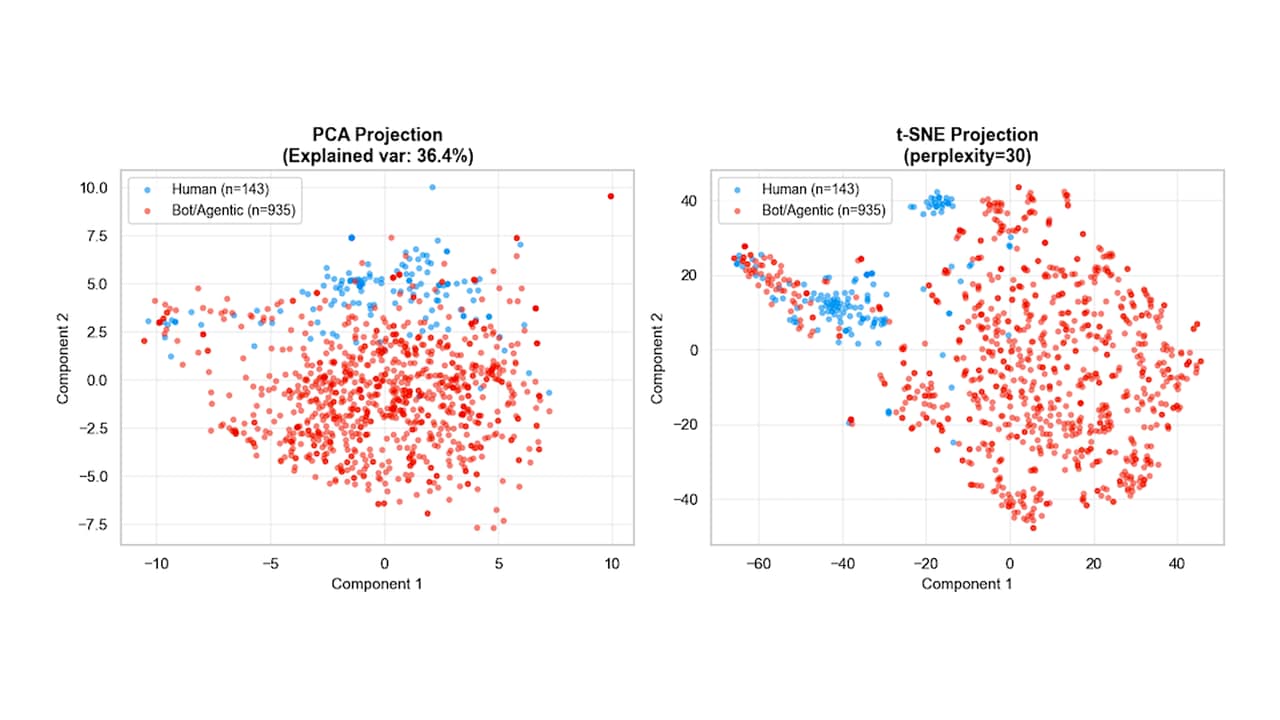
2次元空間に投影すると、Transformerモデルが学習した人間とエージェントの埋め込み表現の間に、比較的明確な分離が見られます(図参照)。SVMによる超平面の決定境界のような非常に単純なアプローチは、十分な性能を発揮しませんでした。一方、浅いMLPネットワークは、各クラスを識別する境界を学習し、限られた量のラベル付き学習データでも、比較的良好な汎化性能を示しました。
エージェント型AIブラウザーツールは、Webトラフィックに真に新しい時代をもたらしつつあります。そこでは、1つのセッション内に人間とAIの両方によるテレメトリが混在する可能性があり、従来の検知モデルでは、こうした行動を捉えるようには設計されていません。
今回紹介したアーキテクチャは、マウス操作が極めて少ないセッションであっても、そのふるまいを体系的に分析するための方法を提供します。それは、数百万件のラベルなしシーケンスからふるまいパターンを学習する自己教師ありTransformerと、慎重に収集したエージェント型セッションのラベル付きデータを用いて学習した軽量な分類器を組み合わせたものです。
このシリーズのパート2では、このモデルを実際に検証します。リクエスト単位およびセッション単位での検知性能指標を示すとともに、異なる顧客Webサイト間でふるまい特性がどの程度汎化するのかを検証し、エージェント型セッションが人間によるセッションと比べてどのように見えるのかを可視化します。また、実環境への導入において「運用上の適合率」が何を意味するのか、そして本番環境で利用可能な機能へと発展させるために何が必要なのかについても説明します。
この投稿で紹介した研究は、Akamaiの脅威リサーチチームおよびデータサイエンスチームによって実施されました。ラベル付きエージェント型データセットは、BMPが導入された顧客Webサイトを使用し、標準化されたプロトコルに従って収集および匿名化しました。

© 2026 Akamai Technologies