Michael Sparkman
Michael Sparkman 是 Akamai 的数据科学家。他在灾害救援项目以及反欺诈与安全分析领域拥有 6 年工作经验,重点深耕爬虫程序自动化技术。在 Akamai,他负责研究新型自动化威胁,并与客户紧密合作以确保其安全态势保持稳固。
自主 AI 浏览器智能体催生了一种新型的 Web 流量,它在运行时会产生稀疏且极度精简的行为遥测数据。
传统的爬虫程序检测模型无法对这些智能体进行评估,因为其超过 98% 的请求几乎没有鼠标移动。
Akamai 开发了一个概念验证掩码自动编码器 Transformer 模型,该模型会将鼠标遥测数据视为语言词元,以用于分析短事件序列。
一个基于 Transformer 嵌入训练的轻量级分类器成功将智能体自动化与稀疏的人类会话区分开来,在类别极度不平衡的情况下依然实现了高准确率。
一种新型访客正在浏览您的网站——它的鼠标移动方式与您的预期不同。在过去一年里,一种新型 AI 工具应运而生,它们的功能已不再局限于回答问题:它会接管您的浏览器并自动执行操作。
Perplexity Comet、OpenAI Atlas 以及 Claude Chrome Extension 等工具在接收到自然语言提示(例如,“Find me a flight to Boston for under $300 and book it”)后,能够自主在开放网络中进行浏览以完成该任务。并无真人在操作鼠标和浏览页面——只有 AI 智能体代替人类用户在您的网站上进行点击和输入操作。
这种自动化技术也称为“控制浏览器”模式,而它正催生出一种既非传统爬虫程序流量,也非人类流量的全新 Web 流量。在 Akamai,我们希望了解此类流量在遥测层面的特征以及我们是否能够对其进行识别。
本博文是该系列博文的第一篇(共两篇),其中介绍的工作属于概念验证 (PoC) 研究;我们计划在未来将其开发成一项更强大的生产级功能。
请注意:在我们的研究工作完成之后,OpenAI 宣布下线 Atlas 产品。尽管发生了这一变化,我们的研究仍为 AI 智能体如何控制和导航浏览器提供了宝贵的见解。
多年以来,Web 安全领域一直基于二元爬虫程序检测模式运作:请求要么来自人类,要么来自爬虫程序。爬虫程序分为两类:第一类是简单的低复杂度内容爬取程序,它们根本不会试图伪装成人类;第二类则是高级伪装者,它们能够生成模拟的鼠标移动轨迹、改变操作时机,并竭尽所能地模仿人类的行为。
自动化模式的智能体不属于上述两种爬虫程序类别的任何一种。它们并非在刻意伪装;只是其操作模式与人类不同。当智能体访问某个网页时,它会直接跳转到目标部分。
在读取内容时,它不会漫无目的地移动鼠标。
它在点击前不会悬停鼠标指针,
也不会进行滚动浏览。
它的点击精准,输入高效,并在完成所需操作后继续执行其他操作。
最终形成了一种稀疏、机械化且精简的行为特征。这就引发了一个检测难题,而现有的工具并非为解决该问题而设计。
Akamai Bot Manager Premier 会收集丰富的行为遥测数据,即从每个已部署监控代码的网页传输过来的鼠标事件序列(包括移动、点击和滚动)。我们现有的行为模型正是通过分析这些序列来区分人类和爬虫程序的。这些模型很擅长进行此类区分。但它们都有一个硬性条件:序列中必须有足够数量的事件才能进行有意义的对比。
当我们将上述模型应用于从自动化模式下运行的 Comet 与 Atlas 中收集的数百个会话时,发现结果如下:
63.2% 的智能体自动发布请求不包含任何鼠标事件
35.8% 的请求所包含的事件数量低于最低阈值
只有 1.0% 的请求包含足够数量的移动事件,可供系统进行评估
现有的鼠标移动模型仅将不到 1% 的智能体总请求标记为可疑。模型并没有失效,而是它们从未获得运行的机会。自动化模式的智能体不会生成鼠标遥测数据,因为它们通常不使用鼠标。它们通过程序化方式进行页面导航。遥测数据之所以稀疏,并不是因为智能体在规避检测,而是因为它根本不产生类似人类的交互痕迹。
弥合“已评估”与“可评估”之间的鸿沟是需要解决的核心问题。
为了构建一个能够处理稀疏遥测数据的模型,我们需要改变设计思路。
可以像对待词汇一样去理解鼠标事件。孤立的单个词几乎无法揭示句子作者身份。然而,隐含在词中的模式(包括其节奏、相对频率以及词与词之间的停顿)可以告诉我们很多信息。由智能体编写的语句简洁明了且目的明确,其中没有任何离题、回溯或无关紧要的凑数内容。而人类编写的句子更加繁复,但也蕴含着更丰富的细节。
正是这种类比,推动了我们建模方案的形成。并且它不仅是隐喻性的,而且是结构性的。我们在微调大语言模型 (LLM) 方面的背景经验,为我们揭示了一个直接的相似之处:使 Transformer 模型能够对句子中词法词元间的关系进行建模的注意力机制,也可应用于对行为序列中鼠标事件之间的关系进行建模。
在 Transformer 的键/查询注意力模块中,每个词元都会关注其他所有词元,从而使模型能够学习到哪些词元对彼此的含义最为相关,而不受距离的限制。将此逻辑应用于鼠标行为遥测时,这意味着模型能够学习少量事件之间的关系。我们发现,此类 Transformer 模型能够有效学习并利用这些关系,即便在序列较短的情况下也是如此。
我们没有构建一个需要长事件序列才能进行评估的模型,而是训练模型去理解短序列的含义,以便将智能体的稀疏且目的明确的鼠标“词汇”与人类区分开来。
以下架构展示了一种概念验证设计。在初步探究阶段,我们有意将训练数据规模与模型容量限制在适度水平;在生产部署时,则需要采用更大规模的模型和更全面的标注数据收集机制。
在将会话归类为智能体会话还是人类会话之前,我们首先必须让模型学习正常鼠标行为的底层结构。
我们对掩码自动编码器 Transformer 这一自我监督自然语言处理架构进行了改造,并将其用于行为遥测分析。该模型使用了约 350 万条来自 Bot Manager Premier 真实遥测数据的未标注鼠标事件序列进行训练。在训练过程中,每个序列中 35% 的事件被随机屏蔽,以促使模型利用上下文进行重建,该过程不需要任何人工标注。
轻量级架构
该架构采用了轻量化设计:
44,000 个参数
3 个转换器层
4 个注意力头
每个序列固定的 64 维嵌入
以时间编码替代位置编码编码时间而非位置
一项关键的设计决策是,使用累积时间戳替换了标准的位置编码(例如,第 1 个事件、第 2 个事件)。对已用时间应用正弦编码,其作用机制类似于傅里叶分解,能够将每个时间戳同时投影到多个频率上。
高频分量负责捕捉快速事件之间的微小间隙
低频分量负责捕捉整体会话节奏
这迫使模型将时序模式作为一级特征进行学习。AI 智能体特有的那种漫长且不规律的停顿(有时两次点击之间相隔数秒),不再是序列长度的附带产物,而成为了一个有意义的信号。
利用一个生成 64 维行为嵌入的预训练 Transformer 模型,我们训练了一个小型受监督分类器来检测智能体行为——通过在部署了 Bot Manager Premier 的真实客户网站上运行 Comet、Atlas 和 Claude Chrome 扩展程序,收集了2,190 个已标注的智能体序列。
我们的团队使用标准化提示来操作这些工具:
“Navigate to the product page and add item X to the cart”
“Find the login page”
“Compare items in category Y”
我们随后收集了由此产生的 Bot Manager Premier 会话数据。人类基准数据提取自同一批客户资产。
将这些因素结合起来后产生了一个显著的类别不平衡问题:人类会话与智能体会话的比例约为 85:1。为了解决此问题,我们引入了类别加权损失函数,并针对智能体少数类进行了大量的数据增强(包括添加高斯噪声、特征漏失以及随机时间缩放)。
第二阶段分类器是一个浅层多层感知机 (MLP)——它构建在 64 维嵌入之上,包含两个隐藏层(64 → 32 个单元)。我们将该方法与单类支持向量机 (SVM)、隔离森林以及变分自动编码器 (VAE) 方法进行了对比(见表)。受监督 MLP 的表现显著优于所有替代方案,包括那些通常被预期在未见过的数据上泛化能力更强的单类方法。
| 方法 | ROC-AUC | PR-AUC | 备注 |
|---|---|---|---|
| 单类 SVM | 0.797 | 0.044 | 仅使用人类数据进行训练 |
| 隔离森林 | 0.833 | 0.038 | 在有意义的阈值下,召回率接近于零 |
| VAE + 基于能量的损失 | 0.882 | 0.410 | 由潜力,但难以调整 |
| 浅层 MLP(最终方案) | 0.981 | 0.661 | 所选方法 |
第二阶段分类模型对比显示,浅层 MLP 表现更出色
关键见解
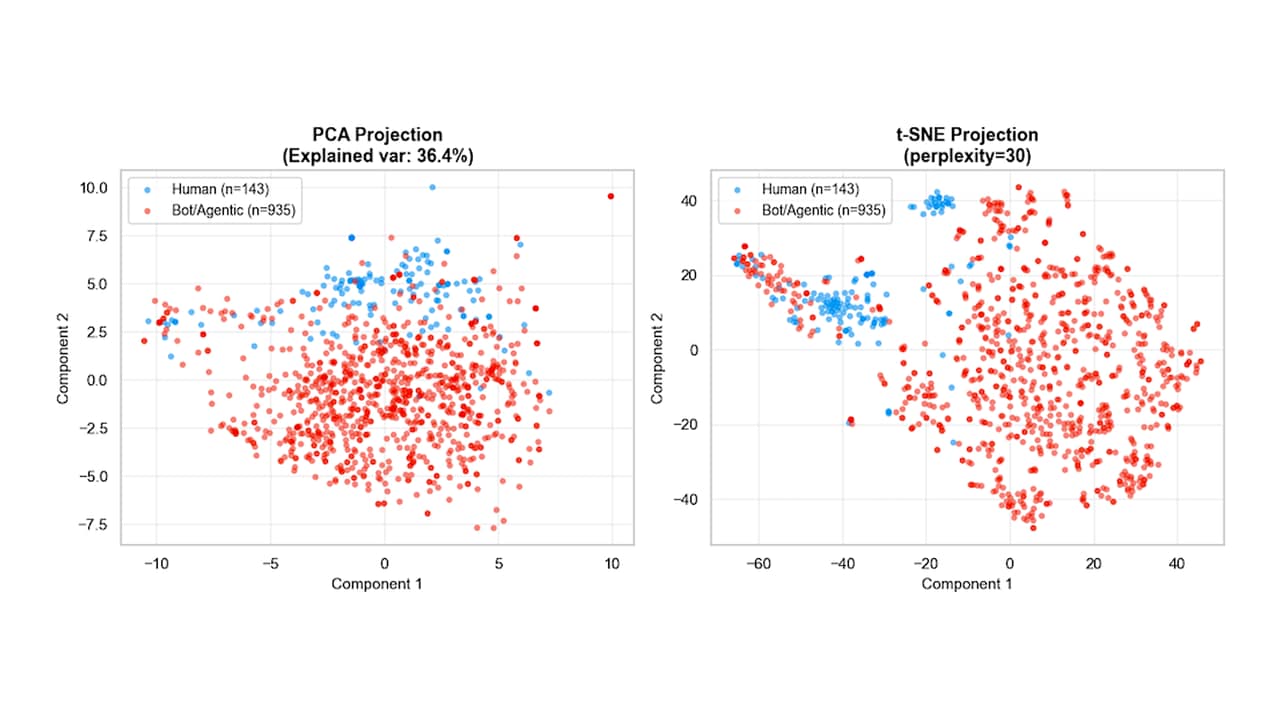
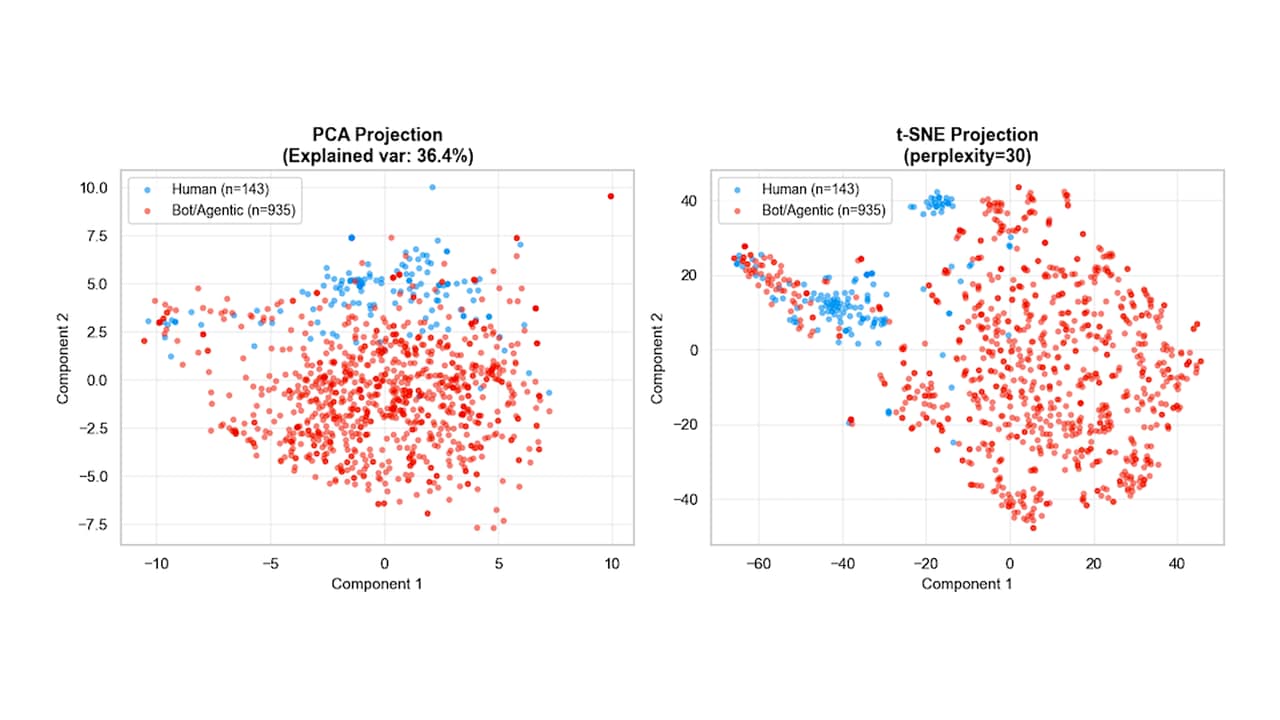
智能体行为并非完全“超出”人类行为分布范围;它与稀疏的人类会话存在部分重叠,例如那些仅进行一次直接点击便离开的用户。检测智能体需要学习判别边界,而不仅仅是标记异常值。
投影到二维空间后,我们可以观察到,Transformer 模型学习到的人类嵌入与智能体嵌入之间呈现出相对清晰的分离(见图)。使用 SVM 构建超平面决策边界等非常简单的方法效果不佳,但浅层 MLP 网络能够学会区分不同类别,并且在标注训练数据有限的情况下依然具备较好的泛化能力。
智能体 AI 浏览器工具正引领我们进入一个真正全新的 Web 流量时代——在这个时代中,会话可以融合人类和人工智能的遥测数据,而现有的检测模型并未针对此类情况进行设计。
本文介绍的架构提供了一种合乎原则的方法,让我们对最稀疏的鼠标轨迹序列也能进行推理分析:首先采用一个自我监督 Transformer 模型,负责从数百万条未标注的序列中学习行为结构;然后采用一个轻量级分类器,该分类器使用精心收集的标注智能体会话集进行训练。
在该系列博文的第二篇中,我们将对该模型进行测试。我们将分享请求级和会话级的检测指标,展示这些行为特征如何在不同的客户网站上实现泛化,并通过可视化方式对比智能体会话与人类会话的差异。我们还将探讨在真实部署环境中操作精度的意义以及开发生产级能力需要具备哪些条件。
本文所述的研究由 Akamai 威胁研究和数据科学团队共同完成。已标注智能体数据集是按照标准化流程在配备 BMP 的客户网站上收集的并进行了匿名化处理。

©2026 Akamai Technologies