Passa al contenuto principale
Background

Identificazione dell'automazione agentica con la telemetria comportamentale

August 19, 2026 by Michael Sparkman e Daniel McAndrew

Condividi

Concetti chiave

Gli agenti del browser AI autonomi generano una nuova categoria di traffico web che opera con una telemetria comportamentale meno frequente ed estremamente economica.

I modelli di rilevamento dei bot tradizionali non riescono a valutare questi agenti perché più del 98% delle loro richieste contiene un movimento del mouse minimo o nullo.

Akamai ha sviluppato un modello MAT (Masked Autoencoder Transformer) di tipo PoC (Proof-of-Concept), che tratta la telemetria del mouse come i token linguistici per analizzare sequenze di eventi brevi.

Un classificatore agile, che è stato addestrato all'incorporamento del trasformatore, distingue correttamente l'automazione autentica dalle sessioni degli utenti meno frequenti, ottenendo un'elevata precisione nonostante un enorme squilibrio di classe.
 

Un nuovo tipo di visitatore sta visitando il tuo sito web, ma non muove il mouse come ci si aspetterebbe. Nel corso dell'ultimo anno, è emersa una categoria di strumenti basata sull'intelligenza artificiale che non risponde solo alle domande, ma assume il controllo del browser e agisce autonomamente.

Vari strumenti come Perplexity Comet, OpenAI Atlas e Claude Chrome Extension, che ricevono una richiesta in linguaggio naturale (come "Trova un volo per Boston a meno di 300 dollari e prenotalo"), possono quindi navigare autonomamente su Internet per completare l'attività. Nessun utente muove il mouse o legge la pagina: c'è solo un agente AI, che fa clic e digita il testo tramite il tuo sito per conto di un utente.

Questa automazione è nota anche come modalità di "controllo del browser" e genera una categoria di traffico web che è diversa sia dal traffico dei bot tradizionale che dal traffico degli utenti. In Akamai, volevamo capire come si presenta questo traffico a livello di telemetria e come riuscire ad identificarlo.

Il lavoro descritto in questo post del blog, che è il primo di una serie costituita da due parti, è un'attività di ricerca basata su una PoC (Proof-of-Concept), che intendiamo sviluppare in una funzionalità più solida e pronta per la produzione in futuro.

Nota: OpenAI ha annunciato l'interruzione di Atlas dopo il termine della nostra ricerca. Nonostante questo cambiamento, la nostra ricerca fornisce preziose informazioni sul modo in cui gli agenti basati sull'intelligenza artificiale possono controllare e utilizzare i browser.

Una terza categoria di traffico

Per anni, la sicurezza web si è basata su un modello di rilevamento dei bot binario: una richiesta proviene dall'uomo o da un bot. I bot rientrano in due categorie: si tratta di crawler semplici e poco sofisticati che non fanno alcun tentativo di apparire simili all'uomo oppure si tratta di strumenti sofisticati che generano movimenti sintetici del mouse, variano i loro tempi e fanno tutto ciò che è in loro potere per imitare il comportamento umano.

Gli agenti in modalità di automazione non rientrano in queste categorie di bot perché non cercano di ingannare nessuno, ma semplicemente non funzionano imitando il comportamento umano. Quando un agente visita una pagina web, va direttamente al suo obiettivo,

  • non sposta il cursore in modo rigido durante la lettura del testo,

  • non muove il mouse prima di fare clic, 

  • non scorre il testo per consultarlo,

  • ma, invece, fa clic con precisione, digita in modo efficiente e procede verso il suo obiettivo.

Pertanto, il suo comportamento risulta non frequente, meccanico ed economico. Ecco perché gli strumenti esistenti trovano difficoltà nel rilevarlo perché non sono stati progettati a questo scopo.

Perché i nostri modelli comportamentali esistenti non sono adeguati

Akamai Bot Manager Premier raccoglie una telemetria comportamentale completa, ossia sequenze di eventi del mouse (spostamenti, clic e azioni di scorrimento) trasmessi da ogni pagina web sottoposta al controllo. I nostri modelli comportamentali esistenti analizzano queste sequenze per distinguere gli esseri umani dai bot e, in questo, sono bravi, ma richiedono una cosa in modo rigido: sono necessari un numero sufficiente di eventi in una sequenza per effettuare un confronto significativo.

Ecco cosa abbiamo scoperto quando abbiamo eseguito questi modelli in occasione delle centinaia di sessioni raccolte da Comet e Atlas in modalità di automazione:

  • Il 63,2% delle richieste di post automatici degli agenti non conteneva eventi del mouse

  • Il 35,8% conteneva un numero di eventi inferiore alla soglia minima

  • Solo l'1% delle richieste conteneva un numero sufficiente di eventi di movimento da poter valutare

Il modello di movimento del mouse esistente ha segnalato come sospetto meno dell'1%delle richieste totali degli agenti. I modelli non fallivano, semplicemente non venivano proprio eseguiti. Gli agenti in modalità di automazione non generano alcuna telemetria del mouse perché, per la maggior parte, non utilizzano proprio un mouse, ma navigano in modo programmatico. La telemetria risulta non frequente, non perché l'agente elude il rilevamento, ma perché semplicemente non produce elementi di interazione simili a quelli umani.

Il divario tra elemento "valutato" e "valutabile" è stato il problema principale da risolvere.

Ridefinire il problema: gli eventi del mouse come linguaggio

Per creare un modello che opera su una telemetria meno frequente, abbiamo dovuto cambiare la nostra concezione e

pensare agli eventi del mouse come alle parole: una sola parola ti dice molto poco di chi ha scritto una frase. Tuttavia, le sequenze di parole, tra cui il ritmo, le relative frequenze e le pause tra di esse, possono dirci molto. Una frase scritta da un agente è economica e mirata, non vi sono incoerenze né ha dubbi o riempie le pause. Una frase scritta dall'uomo è più confusa e più ricca.

Questa analogia ha guidato il nostro approccio alla creazione dei modelli. Si tratta di un'analogia non solo metaforica, ma anche architettonica. I nostri modelli linguistici di grandi dimensioni (LLM) che ottimizzano il background hanno suggerito un'analogia diretta: gli stessi meccanismi di attenzione che consentono ai trasformatori di modellare le relazioni tra i token lessicali in una frase potrebbero essere applicati per modellare le relazioni tra gli eventi del mouse in una sequenza comportamentale. 

Nei blocchi di attenzione della chiave/query di un trasformatore, ogni token aspetta ogni altro token, consentendo ai modelli di apprendere quali token sono più pertinenti al significato di un altro, indipendentemente dalla distanza. Se applicato alla telemetria del mouse, questo approccio indica che un modello può apprendere la relazione tra un numero ridotto di eventi. Inoltre, abbiamo scoperto che questi modelli di trasformatori possono imparare a sfruttare efficacemente tali relazioni anche quando le sequenze sono brevi.

Invece di creare un modello che richiede una lunga sequenza di eventi da valutare, abbiamo preparato un modello per capire cosa significa una breve sequenza per distinguere il "vocabolario" mirato e poco frequente di un agente da quello di un uomo.

La nostra architettura di rilevamento in due fasi

La seguente architettura rappresenta un progetto PoC. La portata dei dati dell'addestramento e della capacità dei modelli è intenzionalmente modesta per un'indagine iniziale; l'implementazione della produzione giustificherebbe modelli più grandi e una raccolta di dati classificati più completa.

Fase 1. Imparare come si presenta il comportamento del mouse

Prima di classificare le sessioni come agentiche o umane, abbiamo dovuto insegnare al nostro modello la struttura sottostante del normale comportamento del mouse.

A tal scopo, abbiamo adattato un MAT (Masked Autoencoder Transformer), un'architettura di elaborazione del linguaggio naturale autonoma, per la telemetria comportamentale. Il modello è stato addestrato su circa 3,5 milioni di sequenze di eventi del mouse non classificati e provenienti dalla telemetria reale di Bot Manager Premier. Durante l'addestramento, il 35% degli eventi in ciascuna sequenza è stato mascherato casualmente per consentire al modello di ricostruire l'evento dal contesto, senza alcuna classificazione manuale.

Architettura agile

L'architettura è agile fin dalla progettazione: 

  • 44.000 parametri

  • 3 livelli del trasformatore

  • 4 teste attenzione

  • Incorporamento fisso a 64 dimensioni per sequenza

Tempo di codifica invece della posizione

Una scelta di progettazione chiave prevede la sostituzione degli encoder posizionali standard (ad es. 1° evento, 2° evento) con indicazioni di data/ora cumulativi.  L'applicazione della codifica sinusoidale al tempo trascorso funge da decomposizione di Fourier, proiettando ogni indicatore di data/ora su più frequenze contemporaneamente.

  • I componenti ad alta frequenza acquisiscono i microgap tra gli eventi rapidi

  • I componenti a bassa frequenza acquisiscono il ritmo complessivo della sessione

Ciò costringe il modello ad apprendere i modelli temporali come una funzione prioritaria. Le pause lunghe e irregolari tipiche degli agenti AI (a volte, diversi secondi tra un clic e l'altro) diventano un segnale significativo piuttosto che un elemento della lunghezza della sequenza.

Fase 2. Imparare a riconoscere gli agenti

Grazie a un trasformatore pre-addestrato che produce incorporamenti comportamentali a 64 dimensioni, abbiamo addestrato un piccolo classificatore supervisionato per l'individuazione dei comportamenti agentici, che ha raccolto 2190 sequenze agentiche classificate eseguendo Comet, Atlas e Claude Chrome Extension sui siti web dei clienti reali, su cui è stato installato Bot Manager Premier.

Il nostro team ha utilizzato questi strumenti impartendo istruzioni standardizzate, del tipo:

  • "Passare alla pagina del prodotto e aggiungere l'articolo X al carrello". 

  • "Trova la pagina di accesso". 

  • "Confronta gli articoli nella categoria Y". 

Abbiamo quindi raccolto le sessioni di Bot Manager Premier che ne risultano. I dati di riferimento umani sono stati ricavati dalle stesse proprietà del cliente.

La combinazione di questi fattori ha creato uno squilibrio significativo nella classe: circa 85 sessioni umane per ogni sessione agentica. Abbiamo affrontato questo problema utilizzando funzioni di perdita ponderata in base alla classe e un ampio aumento dei dati nella classe di minoranza agentica (rumore gaussiano, perdita di funzionalità e scala temporale casuale).

Il classificatore della seconda fase è un MLP (Multi-layer Perceptron) superficiale, con due livelli nascosti (64 → 32 unità) in cima all'incorporamento a 64 dimensioni, che abbiamo confrontato con un'unità SVM (Support Vector Machine) ad una classe, un algoritmo Isolation Forest e un approccio VAE (Variational Autoencoder) (Tabella). Le performance dell'MLP supervisionato sono state eccellenti, in misura sostanziale, in tutte le alternative, compresi i metodi ad una classe che, di solito, generalizzano meglio su dati sconosciuti.


ApproccioROC-AUCPR-AUCNote
SVM ad una classe0,7970,044Addestrato solo su dati umani
Isolation Forest0,8330,038Richiamo quasi nullo alle soglie utili
VAE + perdita energetica0,8820,410Promettente, ma difficile da mettere a punto
MLP superficiale (finale)0,9810,661Approccio specifico

Confronto dei modelli di classificazione della seconda fase, che mostra le migliori performance dell'MLP superficiale

Risultati principali

Il comportamento agentico non è semplicemente "esterno" alla distribuzione umana, ma si sovrappone parzialmente alle sessioni umane meno frequenti, come gli utenti che fanno clic solo una volta e poi lasciano il sito. Il rilevamento degli agenti richiede l'apprendimento di un confine discriminante, non solo l'indicazione di valori anomali.

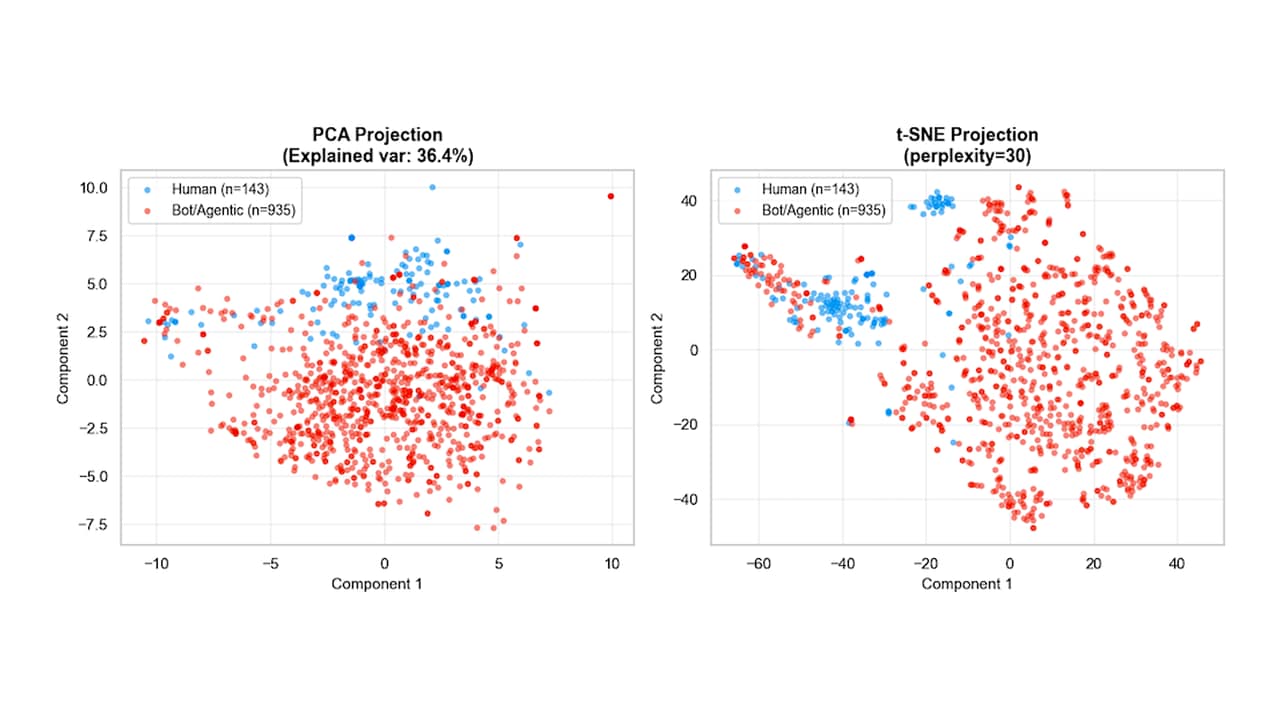
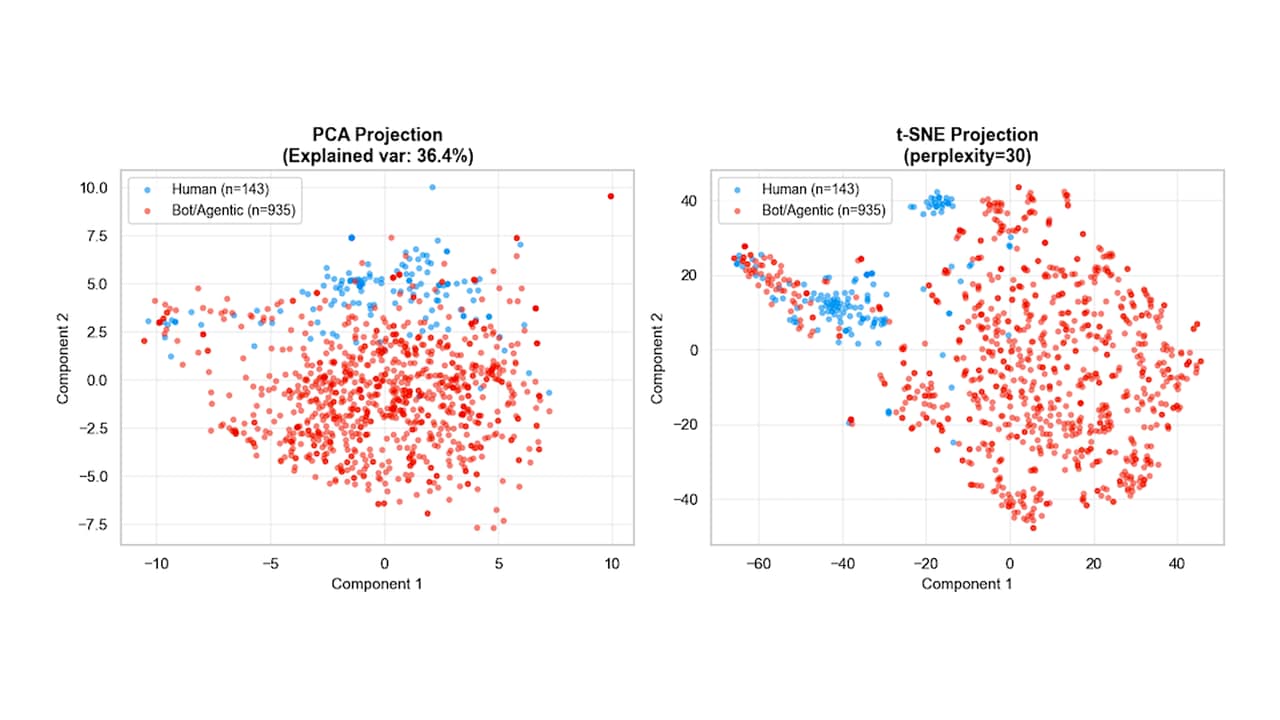
Se ci proiettiamo su uno spazio bidimensionale, possiamo osservare una separazione relativamente chiara tra gli incorporamenti umani e quelli agentici appresi dalla modalità del trasformatore (Figura). Approcci molto semplici, come l'utilizzo di un limite decisionale iperplanare con un SVM, non hanno funzionato molto bene, ma una rete MLP superficiale può imparare a distinguere tra le classi e generalizzare in modo ragionevole anche con pochi dati di addestramento classificati.

Incorporamenti proiettati dallo spazio originale a 64 dimensioni su uno spazio bidimensionale utilizzando l'analisi dei componenti principali (PCA) e gli incorporamenti t-SNE (t-Stochastic Neighbor Embedding)

Le prospettive future

Gli strumenti dell'agentic AI stanno aprendo la strada a una nuova era del traffico web, in cui le sessioni possono combinare la telemetria umana e quella artificiale, per cui i modelli di rilevamento esistenti non sono stati progettati. 

L'architettura descritta in questo post ci offre un modo coerente per ragionare anche sulle sequenze del mouse meno frequenti: un trasformatore autonomo che apprende la struttura comportamentale da milioni di sequenze non etichettate, seguito da un classificatore agile, che è stato addestrato su una serie accuratamente raccolta di sessioni agentiche etichettate.

Nella seconda parte di questa serie, metteremo alla prova il modello, condividendo le metriche di rilevamento a livello di richiesta e di sessione, mostreremo come le firme comportamentali si generino nei diversi siti web dei clienti e vedremo come si presentano le sessioni agentiche rispetto alle sessioni umane. Inoltre, parleremo del significato della precisione operativa in un'implementazione reale e di quello che richiede un percorso verso una funzionalità pronta per la produzione.

La ricerca descritta in questo post è stata condotta dai team Akamai Threat Research e Data Science. Il dataset agentico classificato è stato raccolto e anonimizzato in base ad un protocollo standardizzato utilizzando i siti web dei clienti basati su BMP.

Informazioni sull'autore

Michael Sparkman image

Michael Sparkman

Michael Sparkman is a Data Scientist at Akamai. He has 6 years experience working on disaster and relief projects and fraud and security analytics with a focus on bot automation. At Akamai, he researches new automation threats and works with customers to keep their security postures strong.

Daniel Estevan McAndrew

Daniel McAndrew

Daniel Estevan McAndrew is a Senior Data Scientist at Akamai, where he has spent five years developing machine-learning models for bot detection and abuse prevention. His work spans behavioral telemetry analysis and large-scale anomaly detection across Akamai Bot & Agent Control products. Before joining Akamai, he worked at Intel as a Software Engineer in Computer Vision for live sports broadcasting. He lives in Oakland, California, where he can usually be found hiking with his partner and two huskies.