Zum Hauptinhalt springen
Background

Erkennung agentischer Automatisierung mit Verhaltenstelemetrie

August 19, 2026 by Michael Sparkman und Daniel McAndrew

Teilen

Wichtige Erkenntnisse

Autonome KI‑Browseragenten generieren eine neue Kategorie von Webtraffic, der mit einer geringen, äußerst wirtschaftlichen Verhaltenstelemetrie arbeitet.

Herkömmliche Bot-Erkennungsmodelle können diese Agenten nicht bewerten, da mehr als 98 % ihrer Anfragen nur wenige oder sogar gar keine Mauszeiger-Bewegungen umfassen.

Akamai hat ein Proof-of-Concept-Modell für einen MAE-Transformer entwickelt, das Mauszeiger-Telemetrie wie Sprachtoken behandelt, um kurze Ereignisabfolgen zu analysieren.

Ein kompakter Klassifikator, der mit Transformer-Einbettungen trainiert wurde, unterscheidet agentische Automatisierung erfolgreich von menschlichen Sitzungen mit geringer Aktivität. Hierbei erreicht er trotz extremem Klassenungleichgewicht eine hohe Genauigkeit.
 

Eine neue Art von Besucher nutzt Ihre Website – und diese Besucher bewegen den Mauszeiger nicht so, wie Sie es erwarten. Im vergangenen Jahr hat sich eine Kategorie von KI-Tools entwickelt, die nicht nur Fragen beantwortet: Sie steuern Ihren Browser und erledigen Aufgaben.

Tools wie Perplexity Comet, OpenAI Atlas und die Claude-Erweiterung für Chrome erhalten einen Prompt in natürlicher Sprache (z. B. „Finde einen Flug nach Berlin für weniger als 200 Euro und buche ihn“) und können dann autonom das Internet nutzen, um die Aufgabe abzuschließen. Es gibt also keine manuelle Mausbedienung und keine Menschen, die die Seite lesen – nur einen KI-Agenten, der sich im Namen eines Menschen durch Ihre Website klickt und Informationen eintippt.

Diese Automatisierung wird auch als „Browser steuern“-Modus bezeichnet und generiert eine Kategorie von Webtraffic, bei der es sich weder um klassischen Bot- noch um menschlichen Datenverkehr handelt. Wir bei Akamai wollten verstehen, wie dieser Traffic auf Telemetrieebene aussieht und ob wir ihn identifizieren können.

Die Arbeit, die in diesem Blogbeitrag – Teil 1 einer zweiteiligen Serie – beschrieben wird, ist ein Proof of Concept (PoC) zu Forschungszwecken. Wir beabsichtigen, ihn in Zukunft zu einer leistungsstarken, produktionsfähigen Funktion weiterzuentwickeln.

Hinweis: OpenAI hat nach Abschluss unserer Forschung die Einstellung von Atlas angekündigt. Trotz dieser Änderung bietet unsere Studie wertvolle Einblicke dazu, wie KI‑Agenten Browser steuern und darin navigieren können.

Eine dritte Traffic-Kategorie

Seit Jahren basiert die Websicherheit auf einem binären Bot-Erkennungsmodell: Eine Anfrage ist entweder „menschlich“ oder stammt von einem „Bot“. Diese Bots lassen sich in zwei Kategorien unterteilen: Die erste sind simple Crawler, die nicht versuchen, menschlich zu wirken. Die zweite sind hochentwickelte Nachahmer, die synthetische Mauszeiger-Bewegungen erzeugen, ihr Timing variieren und alles tun, was sie können, um wie ein Mensch zu wirken.

Agenten im Automatisierungsmodus gehören zu keiner der Bot-Kategorien. Sie versuchen nicht, jemanden zu täuschen, sondern arbeiten einfach anders, als ein Mensch es tut. Wenn ein Agent zu einer Webseite navigiert, gelangt er direkt zu seinem Ziel.

  • Er bewegt den Mauszeiger nicht, während er die Seite liest.

  • Er bewegt den Mauszeiger nicht über Links, bevor er darauf klickt. 

  • Er scrollt nicht, um die Seite zu erkunden.

  • Er klickt präzise, gibt Daten effizient ein und fährt dann fort.

Das Ergebnis ist ein verhaltensbasierter Fingerabdruck, der spärlich, mechanisch und wirtschaftlich ist. Und das führt zu einem Erkennungsproblem, das bestehende Tools nicht lösen können.

Warum bestehende Verhaltensmodelle versagen

Akamai Bot Manager Premier erfasst umfangreiche Telemetriedaten: Abfolgen von Mauszeiger-Ereignissen (Bewegungen, Klicks und Scrollen), die von jeder instrumentierten Webseite übertragen werden. Unsere bestehenden Verhaltensmodelle analysieren diese Abfolgen, um Menschen von Bots zu unterscheiden – und darin sind sie wirklich gut. Aber sie haben eine feste Anforderung: Sie benötigen genügend Ereignisse in einer Abfolge, um einen aussagekräftigen Vergleich anzustellen.

Wir haben diese Modelle auf Hunderte von Sitzungen angewendet, die wir von Comet und Atlas im Automatisierungsmodus erfasst haben. Folgendes haben wir hierbei herausgefunden:

  • 63,2 % der agentischen Anfragen enthielten keinerlei Mauszeiger-Ereignisse.

  • 35,8 % enthielten Ereignismengen unterhalb des minimalen Schwellenwerts.

  • Nur 1,0 % der Anfragen enthielten genügend Bewegungsereignisse, um bewertet zu werden.

Das vorhandene Modell für Mauszeigerbewegungen hat weniger als 1 % der gesamten agentischen Anfragen als verdächtig markiert. Doch die Modelle waren nicht fehlerhaft – sie hatten einfach nie die Chance, ihre Arbeit zu machen. Agenten im Automatisierungsmodus generieren keine Mauszeiger-Telemetrie, da sie größtenteils keine Maus verwenden. Sie navigieren programmgesteuert. Telemetriedaten sind also spärlich – nicht, weil der Agent die Erkennung umgeht, sondern weil er einfach keine menschlichen Interaktionsartefakte erzeugt.

Die Lücke zwischen „bewertet“ und „bewertbar“ war das Kernproblem, das wir lösen mussten.

Neue Denkweise: Mauszeiger-Ereignisse als Sprache

Um ein Modell zu erstellen, das mit der spärlichen Telemetrie funktioniert, mussten wir unsere Denkweise ändern:

Wir mussten uns Mauszeiger-Ereignisse wie Wörter vorstellen. Ein einzelnes Wort sagt nur wenig darüber aus, wer einen Satz geschrieben hat. Aber Muster in Wörtern – einschließlich ihres Rhythmus, ihrer relativen Häufigkeit und Pausen zwischen den Wörtern – können viel aussagen. Ein Satz, der von einem Agenten geschrieben wurde, ist wirtschaftlich und zielgerichtet: Er enthält keine Abschweifungen, kein Zurückrudern und keine überflüssigen Füllwörter. Ein Satz, der von Menschen geschrieben wurde, ist deutlich chaotischer und umfangreicher.

Diese Analogie haben wir für unseren Modellierungsansatz genutzt. Und diese Analogie ist nicht nur metaphorisch, sondern betrifft auch die Architektur. Unsere Hintergrund-Optimierungs‑LLMs (Large Language Models) zeigten eine direkte Parallele: Dieselben Aufmerksamkeitsmechanismen, die es Transformern ermöglichen, Beziehungen zwischen lexikalischen Token in einem Satz zu modellieren, können auch auf Modellbeziehungen zwischen Mauszeiger-Ereignissen in einer Verhaltensabfolge angewendet werden. 

In den Schlüssel-/Abfrage-Aufmerksamkeitsblöcken eines Transformers wird jedes Token auf jedes andere Token bezogen. So können Modelle lernen, welche Token für die Bedeutung der anderen am relevantesten sind, unabhängig von ihrer Entfernung. Wenn wir dieses Modell auf die Mauszeiger-Telemetrie anwenden, kann ein Modell die Beziehung zwischen einer kleinen Anzahl von Ereignissen erlernen. Und wir haben festgestellt, dass diese Transformer-Modelle effektiv lernen können, diese Beziehungen auch dann zu nutzen, wenn die Abfolgen kurz sind.

Anstatt ein Modell zu erstellen, das eine lange Ereignisabfolge zur Bewertung erfordert, haben wir ein Modell darin trainiert, zu verstehen, was eine kurze Abfolge bedeutet, um das spärliche, zielgerichtete Mauszeiger-„Vokabular“ eines Agenten vom menschlichen Vokabular zu unterscheiden.

Unsere zweistufige Erkennungsarchitektur

Die folgende Architektur stellt ein PoC-Design dar. Der Umfang der Trainingsdaten und die Modellkapazität sind absichtlich gering, um eine erste Untersuchung zu ermöglichen. Eine Produktionsbereitstellung würde größere Modelle und eine umfassendere, gekennzeichnete Datensammlung erfordern.

Phase 1: Lernen, wie das Mauszeiger-Verhalten aussieht

Bevor wir Sitzungen als „agentisch“ oder „menschlich“ klassifizieren konnten, mussten wir unserem Modell zunächst die zugrunde liegende Struktur des normalen Mauszeiger-Verhaltens vermitteln.

Wir haben einen Masked AutoEncoder Transformer – eine selbstüberwachte NLP‑Architektur (Natural Language Processing) – für Verhaltenstelemetrie angepasst. Das Modell wurde mit etwa 3,5 Millionen ungekennzeichneten Mauszeiger-Ereignisabfolgen trainiert, die aus echter Bot Manager Premier-Telemetrie stammten. Während des Trainings wurden 35 % der Ereignisse in jeder Abfolge zufällig maskiert, damit das Modell sie aus dem Kontext rekonstruieren konnte – ganz ohne manuelle Kennzeichnung.

Schlanke Architektur

Die Architektur ist bewusst kompakt: 

  • 44.000 Parameter

  • 3 Transformer-Ebenen

  • 4 Aufmerksamkeitsköpfe

  • Feste 64‑dimensionale Einbettung pro Sequenz

Codierung der Zeit statt der Position

Eine wichtige Designentscheidung bestand darin, Standard-Positionscodierungen (z. B. 1. Ereignis, 2. Ereignis) durch kumulative Zeitstempel zu ersetzen.  Die Anwendung einer sinusförmigen Codierung auf die verstrichene Zeit dient als Fourier-Zerlegung, bei der jeder Zeitstempel gleichzeitig auf mehrere Frequenzen projiziert wird.

  • Hochfrequenz-Komponenten erfassen Mikrolücken zwischen schnellen Ereignissen.

  • Niederfrequenz-Komponenten erfassen den allgemeinen Sitzungsrhythmus.

Das zwingt das Modell dazu, Zeitmuster als First-Class-Feature zu erlernen. So werden die langen, unregelmäßigen Pausen, die für KI‑Agenten typisch sind (manchmal mehrere Sekunden zwischen Klicks), zu einem aussagekräftigen Signal statt zu einem Artefakt der Abfolgelänge.

Phase 2: Lernen, Agenten zu erkennen

Mit einem vortrainierten Transformer, der 64-dimensionale Verhaltenseinbettungen generiert, haben wir einen kleinen überwachten Klassifikator darin trainiert, agentisches Verhalten zu erkennen. Dabei haben wir 2.190 gekennzeichnete agentische Abfolgen erfasst, indem wir Comet, Atlas und die Claude-Erweiterung für Chrome auf echten, mit Bot Manager Premier instrumentierten Kundenwebsites ausgeführt haben.

Unser Team hat diese Tools mit standardisierten Prompts bedient:

  • „Navigiere zur Produktseite und füge Artikel X zum Warenkorb hinzu.“ 

  • „Finde die Anmeldeseite.“ 

  • „Vergleiche Artikel in Kategorie Y.“ 

Anschließend haben wir die daraus resultierenden Bot Manager Premier-Sitzungen gesammelt. Gleichzeitig haben wir menschliche Baseline-Daten von denselben Kundenressourcen abgerufen.

Die Kombination dieser beiden Datensätze führte zu einem signifikanten Klassenungleichgewicht: etwa 85 menschliche Sitzungen auf eine agentische Sitzung. Wir haben dieses Ungleichgewicht mit klassengewichteten Verlustfunktionen und umfangreicher Datenerweiterung in der agentischen Minderheitenklasse behoben (Gaußsches Rauschen, Feature-Dropout und zufällige temporale Skalierung).

Der Klassifikator der zweiten Stufe ist ein flaches Multi-Layer-Perzeptron (MLP) – mit zwei versteckten Schichten (64 → 32 Einheiten) zusätzlich zur 64‑dimensionalen Einbettung. Wir haben dies mit einer Ein-Klassen-Support-Vektor-Maschine (SVM), einem Isolation Forest und einem VAE-Ansatz (Variational AutoEncoder) verglichen (siehe Tabelle). Das überwachte MLP übertraf alle Alternativen deutlich, einschließlich der Ein-Klassen-Methoden, von denen man normalerweise erwartet, dass sie sich besser für unbekannte Daten verallgemeinern lassen.


AnsatzROC-AUCPR-AUCAnmerkungen
Ein-Klassen-SVM0,7970,044Nur mit menschlichen Daten trainiert
Isolation Forest0,8330,038Nahezu null Recall bei nützlichen Schwellenwerten
VAE + energiebasierter Verlust0,8820,410Vielversprechend, aber schwer abzustimmen
Flaches MLP (final)0,9810,661Ausgewählter Ansatz

Vergleich des Klassifizierungsmodell der zweiten Stufe, der zeigt, dass das flache MLP eine bessere Performance liefert

Wichtige Erkenntnis

Das agentische Verhalten liegt nicht einfach „außerhalb“ der menschlichen Verteilung, sondern überschneidet sich teilweise mit menschlichen Sitzungen mit geringer Aktivität, wie z. B. bei Nutzern, die einmal gezielt klicken und die Seite dann verlassen. Um Agenten zu erkennen, müssen Modelle eine unterscheidende Grenze erlernen, anstatt einfach nur Ausreißer zu markieren.

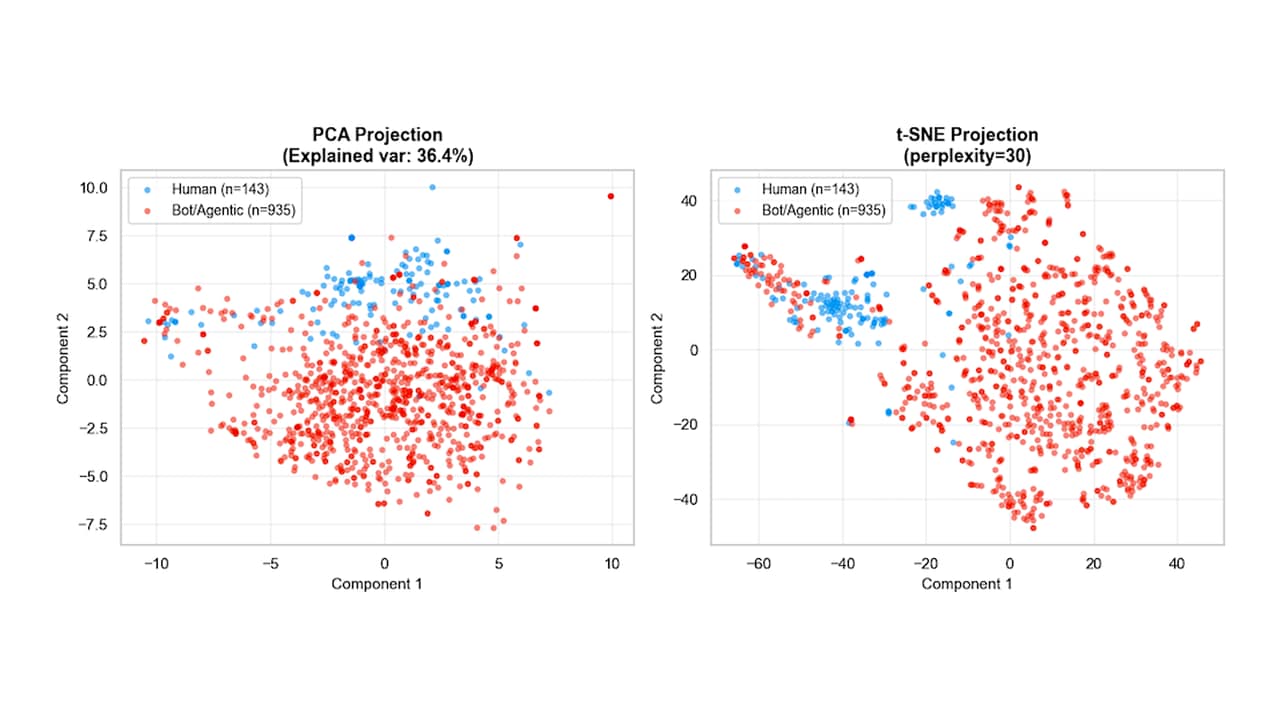
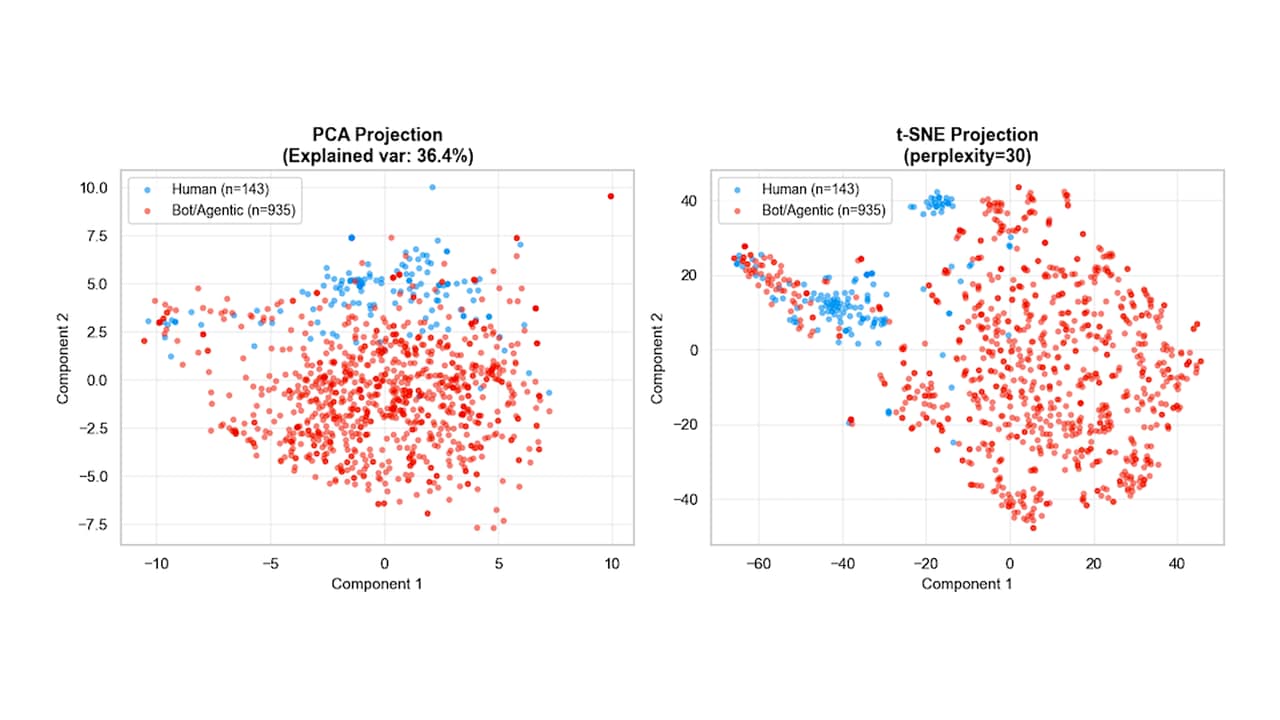
Wenn wir die Daten auf einen zweidimensionalen Raum projizieren, können wir eine relativ klare Trennung zwischen den menschlichen und agentischen Einbettungen erkennen, die vom Transformer-Modus erlernt wurden (siehe Abbildung). Sehr einfache Ansätze, wie die Verwendung einer Hyperebenen-Entscheidungsgrenze mit einer SVM, funktionierten nicht sehr gut, doch ein flaches MLP‑Netzwerk kann lernen, zwischen den Klassen zu unterscheiden und mit begrenzten Trainingsdaten relativ gut zu verallgemeinern.

Projizierte Einbettungen aus dem ursprünglichen 64‑dimensionalen Raum auf einen zweidimensionalen Raum, unter Verwendung einer Hauptkomponentenanalyse (Principal Component Analysis, PCA) und t‑verteilten stochastischen Nachbareinbettungen (t‑Stochastic Neighbor Embeddings, t-SNE)

Nächste Schritte

Agentische KI‑Browsertools läuten eine völlig neue Ära des Webtraffics ein, in der die Grenze zwischen menschlicher und künstlicher Telemetrie verschwimmt – und vorhandene Erkennungsmodelle sind nicht darauf ausgelegt, sie zu erkennen. 

Die in diesem Beitrag beschriebene Architektur bietet uns einen grundlegenden Ansatz, um selbst die spärlichsten Mauszeigerabfolgen zu analysieren: einen selbstüberwachten Transformer, der Verhaltensstrukturen aus Millionen ungekennzeichneten Abfolgen erlernt, gefolgt von einem kompakten Klassifikator, der mit einer sorgfältig zusammengestellten Sammlung gekennzeichneter agentischer Sitzungen trainiert wurde.

Im zweiten Teil dieser Reihe werden wir das Modell auf die Probe stellen. Wir werden Erkennungsmetriken auf Anfrage- und Sitzungsebene vorstellen; zeigen, wie sich die Verhaltenssignaturen für verschiedene Kundenwebsites verallgemeinern lassen; und visualisieren, wie agentische Sitzungen im Vergleich zu menschlichen Sitzungen aussehen. Außerdem werden wir erörtern, was operative Präzision in einer realen Bereitstellung bedeutet – und was nötig ist, um eine produktionsreife Lösung zu entwickeln.

Die in diesem Beitrag beschriebenen Forschungsergebnisse wurden von den Akamai-Teams für Bedrohungsforschung und Datenwissenschaft durchgeführt. Der gekennzeichnete agentische Datensatz wurde gemäß einem standardisierten Protokoll unter Verwendung von BMP-instrumentierten Kundenwebsites erfasst und anonymisiert.

Über den Autor

Michael Sparkman image

Michael Sparkman

Michael Sparkman is a Data Scientist at Akamai. He has 6 years experience working on disaster and relief projects and fraud and security analytics with a focus on bot automation. At Akamai, he researches new automation threats and works with customers to keep their security postures strong.

Daniel Estevan McAndrew

Daniel McAndrew

Daniel Estevan McAndrew is a Senior Data Scientist at Akamai, where he has spent five years developing machine-learning models for bot detection and abuse prevention. His work spans behavioral telemetry analysis and large-scale anomaly detection across Akamai Bot & Agent Control products. Before joining Akamai, he worked at Intel as a Software Engineer in Computer Vision for live sports broadcasting. He lives in Oakland, California, where he can usually be found hiking with his partner and two huskies.