Para crear un modelo que funcione con telemetría dispersa, necesitábamos cambiar nuestro encuadre.
Piense en los eventos de ratón de la forma en que pensaría en las palabras. Una sola palabra le dice muy poco sobre quién escribió una frase. Pero los patrones que hay en las palabras, como el ritmo, las frecuencias relativas y las pausas entre ellas, pueden decir mucho. Una frase escrita por un agente es económica y con un propósito directo; no se va por las ramas, ni duda, ni usa palabras de relleno. Una frase escrita por humanos es más compleja y más rica.
Esta analogía impulsó nuestro enfoque de modelado. Y esta analogía no es solo metafórica, sino también arquitectónica. Nuestros modelos de lenguaje de gran tamaño (LLM) de ajuste preciso en segundo plano sugirieron un paralelismo directo: los mismos mecanismos de atención que permiten a los transformadores modelar relaciones entre tokens léxicos en una frase podrían aplicarse a las relaciones modelo entre los eventos de ratón en una secuencia de comportamiento.
En los bloques de atención clave/consulta de un transformador, cada token atiende a otro token, lo que permite a los modelos aprender qué tokens son más relevantes para el significado de otro, independientemente de la distancia. Esto aplicado a la telemetría del ratón, significa que un modelo puede aprender la relación entre un pequeño número de eventos. Y descubrimos que estos modelos de transformador pueden aprender eficazmente a explotar estas relaciones incluso cuando las secuencias son cortas.
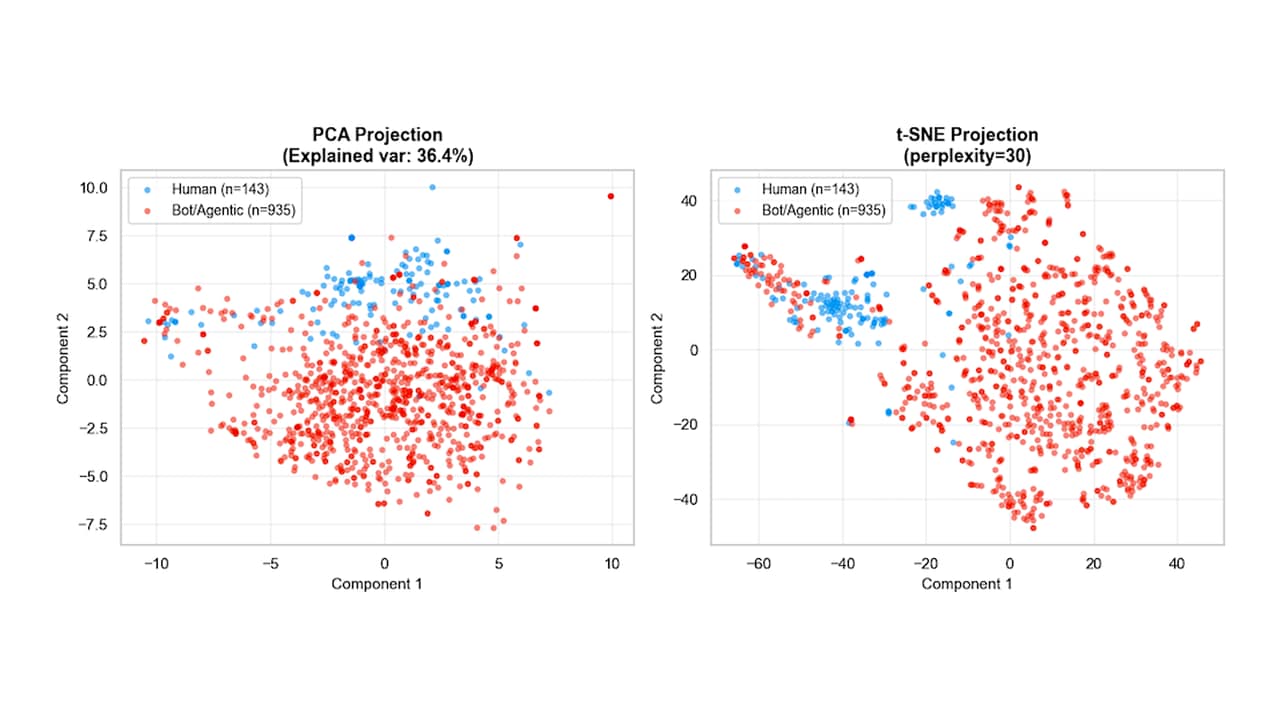
En lugar de construir un modelo que requiere una larga secuencia de eventos para evaluar, entrenamos un modelo para entender lo que significa una secuencia corta con el fin de distinguir el "vocabulario" disperso y con un propósito del ratón de un agente con respecto al de un humano.