Passer au contenu principal
Background

Identifier l'automatisation agentique grâce à la télémétrie comportementale

August 19, 2026 by Michael Sparkman et Daniel McAndrew

Partager

Points à retenir

Les agents de navigation IA autonomes génèrent une nouvelle catégorie de trafic Web, caractérisée par une télémétrie comportementale réduite à l'essentiel.

Les modèles traditionnels de détection de bots ne parviennent pas à évaluer ces agents, car plus de 98 % de leurs requêtes contiennent très peu, voire aucun mouvement de souris.

Akamai a développé une preuve de concept reposant sur un modèle Masked Autoencoder Transformer qui traite la télémétrie de la souris comme des jetons de langage, afin d'analyser de courtes séquences d'événements.

Un classificateur léger entraîné à partir des représentations produites par le transformeur permet de distinguer avec précision l'automatisation agentique des sessions humaines à faible activité, et ce malgré un fort déséquilibre entre les classes.
 

Un nouveau type de visiteur navigue désormais sur votre site Web, et il ne déplace pas sa souris comme vous pourriez l'imaginer. Au cours de l'année écoulée, une nouvelle catégorie d'outils d'IA a fait son apparition. Ces outils ne se contentent plus de répondre à des questions : ils prennent le contrôle du navigateur et agissent au nom d'un utilisateur.

Des outils comme Perplexity Comet, OpenAI Atlas ou l'extension Claude pour Chrome reçoivent une instruction formulée en langage naturel, par exemple : « Trouve-moi un vol pour Boston à moins de 300 dollars et réserve-le ». Ils peuvent ensuite naviguer en toute autonomie sur le Web afin d'accomplir la tâche demandée. Aucune main humaine ne manipule la souris et personne ne consulte réellement la page. Seul un agent d'IA parcourt votre site, clique et saisit des informations pour le compte d'un utilisateur.

Ce mode d'automatisation, également appelé « mode de contrôle du navigateur », génère une catégorie de trafic Web qui ne correspond ni à l'humain, ni aux bots traditionnels. Chez Akamai, nous voulions comprendre à quoi ressemblait ce trafic au niveau de la télémétrie, et savoir s'il était possible de l'identifier.

Les travaux présentés dans ce premier article d'une série en deux volets constituent une preuve de concept (PoC). À terme, nous prévoyons de les faire évoluer vers une solution plus robuste et adaptée à un déploiement en production.

Remarque : OpenAI a annoncé l'abandon d'Atlas après l'achèvement de nos recherches. Malgré cette évolution, ces travaux apportent des enseignements précieux sur la manière dont les agents d'IA peuvent prendre le contrôle d'un navigateur et interagir de façon autonome avec les sites Web.

Une troisième catégorie de trafic

Depuis des années, la sécurité Web repose sur une vision binaire de la détection des bots : une requête provient soit d'un humain, soit d'un bot. Les bots eux-mêmes se répartissent généralement en deux catégories : les indexeurs simples et peu sophistiqués qui ne cherchent pas à imiter les humains, et les bots avancés qui génèrent des mouvements de souris synthétiques, varient leurs temps de réponse et mettent tout en œuvre pour paraître humains.

Les agents en mode automatisé n'appartiennent à aucune de ces catégories. Ils ne cherchent pas à tromper les systèmes. Ils interagissent simplement avec le Web d'une manière différente de celle d'un utilisateur humain. Lorsqu'un agent accède à une page Web, il se rend directement à sa destination.

  • Il ne déplace pas le curseur sans but pendant qu'il lit le contenu.

  • Il ne laisse pas sa souris survoler un élément avant de cliquer. 

  • Il ne fait pas défiler la page pour l'explorer.

  • Il clique avec précision, saisit les informations efficacement, puis passe à l'étape suivante.

Il en résulte une empreinte comportementale minimaliste, très structurée et réduite au strict nécessaire. Or, ce phénomène crée un problème de détection auquel les outils existants ne sont pas préparés.

Pourquoi nos modèles comportementaux existants passaient à côté

Akamai Bot Manager Premier collecte des données comportementales détaillées, composées de séquences d'événements liés à la souris (mouvements, clics et défilements) transmises depuis toutes les pages Web sur lesquelles la solution était déployée. Nos modèles comportementaux analysent ces séquences afin de distinguer les utilisateurs humains des bots. Ils sont performants dans cet exercice. Toutefois, ils reposent sur une condition indispensable : disposer d'un nombre suffisant d'événements dans une séquence pour effectuer une comparaison pertinente.

Voici ce que nous avons observé en exécutant ces modèles sur plusieurs centaines de sessions collectées auprès de Comet et Atlas fonctionnant en mode automatisé :

  • 63,2 % des requêtes générées par ces agents ne contenaient aucun événement lié à la souris

  • 35,8 % contenaient un nombre d'événements inférieur au seuil minimal requis

  • Seules 1 % des requêtes disposaient d'un nombre suffisant d'événements de mouvement pour pouvoir être évaluées

Le modèle de détection existant basé sur les mouvements de souris a signalé comme suspectes moins de 1 % de l'ensemble des requêtes générées par ces agents. Ce n'est pas que les modèles échouaient ; c'est qu'ils n'avaient pratiquement jamais l'occasion de s'exécuter. Les agents opérant en mode automatisé ne produisent pas de télémétrie de souris, puisqu'ils n'utilisent généralement pas de souris. Ils naviguent de manière programmatique. La télémétrie est donc limitée non pas parce que l'agent tente d'échapper à la détection, mais simplement parce qu'il ne génère pas les traces d'interaction caractéristiques d'un utilisateur humain.

Le principal défi à relever résidait dans l'écart entre les requêtes « évaluées » et les requêtes « évaluables ».

Repenser le problème : traiter les événements liés à la souris comme des unités linguistiques

Pour concevoir un modèle capable d'analyser une télémétrie aussi limitée, nous avons dû revoir notre approche.

Considérez les événements liés à la souris comme des mots. Un mot isolé révèle peu d'informations sur l'auteur d'une phrase. En revanche, les schémas qui se dégagent de l'utilisation des mots, leur rythme, leur fréquence relative ou encore les pauses qui les séparent peuvent en dire beaucoup. Une phrase rédigée par un agent est concise et orientée vers un objectif. Elle ne comporte ni hésitations, ni retours en arrière, ni contenu superflu. Une phrase écrite par un humain est généralement plus désordonnée et plus riche.

Cette analogie a guidé notre démarche de modélisation. Elle n'est pas seulement métaphorique, elle est également architecturale. Notre expérience dans l'optimisation de grands modèles de langage (LLM) a mis en évidence un parallèle direct : les mêmes mécanismes d'attention qui permettent aux transformeurs de modéliser les relations entre les jetons d'une phrase peuvent être utilisés pour modéliser les relations entre les événements liés à la souris dans une séquence comportementale. 

Dans les blocs d'attention key/query (clé/requête) d'un transformeur, chaque jeton peut être mis en relation avec tous les autres. Le modèle apprend ainsi quels éléments sont les plus pertinents pour interpréter la signification d'un autre, quelle que soit leur distance dans la séquence. Ce principe, lorsqu'il est appliqué à la télémétrie de souris, permet au modèle d'apprendre les relations existant entre un petit nombre d'événements. Nos travaux ont montré que ces modèles de type transformeur étaient capables d'apprendre efficacement à tirer parti de ces relations, même lorsque les séquences sont courtes.

Plutôt que de créer un modèle qui nécessite de longues séquences d'événements pour fonctionner, nous avons entraîné un modèle à comprendre ce que signifie une courte séquence, afin de distinguer le « vocabulaire » comportemental restreint mais intentionnel d'un agent de celui d'un utilisateur humain.

Notre architecture de détection en deux étapes

L'architecture présentée ci-dessous correspond à une preuve de concept. Le volume des données d'entraînement et la capacité du modèle ont volontairement été limités dans le cadre de cette étude préliminaire. Un déploiement en production justifierait des modèles plus importants, ainsi qu'une collecte plus exhaustive de données étiquetées.

Étape 1 : apprendre à reconnaître les comportements liés à la souris

Avant de pouvoir déterminer si une session était d'origine humaine ou agentique, nous devions d'abord apprendre au modèle la structure sous-jacente des comportements normaux liés à la souris.

Nous avons adapté un Masked Autoencoder Transformer, une architecture d'apprentissage auto-supervisé issue du traitement automatique du langage naturel, à la télémétrie comportementale. Le modèle a été entraîné sur environ 3,5 millions de séquences d'événements souris non étiquetées, provenant de la télémétrie réelle de Bot Manager Premier. Pendant l'entraînement, 35 % des événements de chaque séquence étaient masqués aléatoirement afin que le modèle reconstitue ces événements à partir de leur contexte, sans nécessiter le moindre étiquetage manuel.

Une architecture légère

L'architecture a volontairement été conçue pour rester légère : 

  • 44 000 paramètres

  • 3 couches de transformeur

  • 4 têtes d'attention

  • Représentation vectorielle (embedding) fixe de 64 dimensions par séquence

Encoder le temps plutôt que la position

L'une des principales décisions de conception a consisté à remplacer les encodages positionnels traditionnels (1er événement, 2e événement, etc.) par des horodatages cumulés.  L'application d'un encodage sinusoïdal au temps écoulé agit comme une décomposition de Fourier et projette chaque horodatage simultanément sur plusieurs fréquences.

  • Les composantes de haute fréquence capturent les micro-intervalles entre événements rapprochés

  • Les composantes de basse fréquence capturent le rythme global de la session

Cette approche oblige le modèle à considérer les schémas temporels comme un élément fondamental. Les longues pauses irrégulières typiques des agents d'IA, qui peuvent parfois atteindre plusieurs secondes entre deux clics, deviennent ainsi un signal révélateur, plutôt qu'un simple artefact de la longueur de la séquence.

Étape 2 : apprendre à reconnaître les agents

Une fois le transformeur préentraîné capable de produire des représentations comportementales de 64 dimensions, nous avons entraîné un petit classificateur supervisé afin de détecter les comportements agentiques. Pour ce faire, nous avons collecté 2 190 séquences agentiques étiquetées en exécutant Comet, Atlas et l'extension Claude pour Chrome sur de véritables sites clients qui avaient déployé Bot Manager Premier.

Notre équipe a utilisé ces outils à partir de prompts standardisés :

  • « Accède à la page produit et ajoute l'article X au panier. » 

  • « Trouve la page de connexion. » 

  • « Compare les articles de la catégorie Y. » 

Nous avons ensuite recueilli les données de télémétrie associées aux sessions Bot Manager Premier obtenues. Les données de référence correspondant au comportement humain provenaient des mêmes sites clients.

La combinaison de ces jeux de données a fait apparaître un important déséquilibre entre les classes : on comptait environ 85 sessions humaines pour une session agentique. Nous avons corrigé ce problème à l'aide de fonctions de perte pondérées par classe et de techniques étendues d'augmentation de données appliquées à la classe minoritaire agentique (bruit gaussien, suppression de caractéristiques et mise à l'échelle temporelle aléatoire).

Le classificateur de deuxième niveau repose sur un perceptron multicouche (MLP) peu profond, composé de deux couches cachées (64 → 32 unités) appliquées aux représentations de 64 dimensions. Nous avons comparé cette approche à plusieurs méthodes alternatives : une machine à vecteurs de support (Support Vector Machine, SVM) à classe unique, un algorithme Isolation Forest et un autoencodeur variationnel (Variational Autoencoder, VAE) (voir le tableau). Le MLP supervisé a largement surpassé toutes ces approches, y compris les méthodes à classe unique, habituellement réputées comme plus performantes pour généraliser sur des données inédites.


ApprocheROC-AUCPR-AUCRemarques
SVM à classe unique0.7970.044Entraînée uniquement à partir de données humaines
Isolation Forest0.8330.038Taux de rappel quasiment nul aux seuils pertinents
VAE + fonction de perte basée sur l'énergie0.8820.410Résultats prometteurs, mais réglage complexe
MLP peu profond (modèle final)0.9810.661Approche retenue

Comparaison des modèles de classification de deuxième niveau mettant en évidence les meilleures performances du MLP peu profond

Enseignement clé

Le comportement agentique ne se réduit pas à un comportement situé « en dehors » du spectre des comportements humains. Il se confond partiellement avec certaines sessions humaines peu actives, par exemple lorsqu'un utilisateur effectue un seul clic ciblé avant de quitter le site. La détection des agents nécessite donc d'apprendre une frontière de décision discriminante, plutôt que de se contenter d'identifier des valeurs aberrantes.

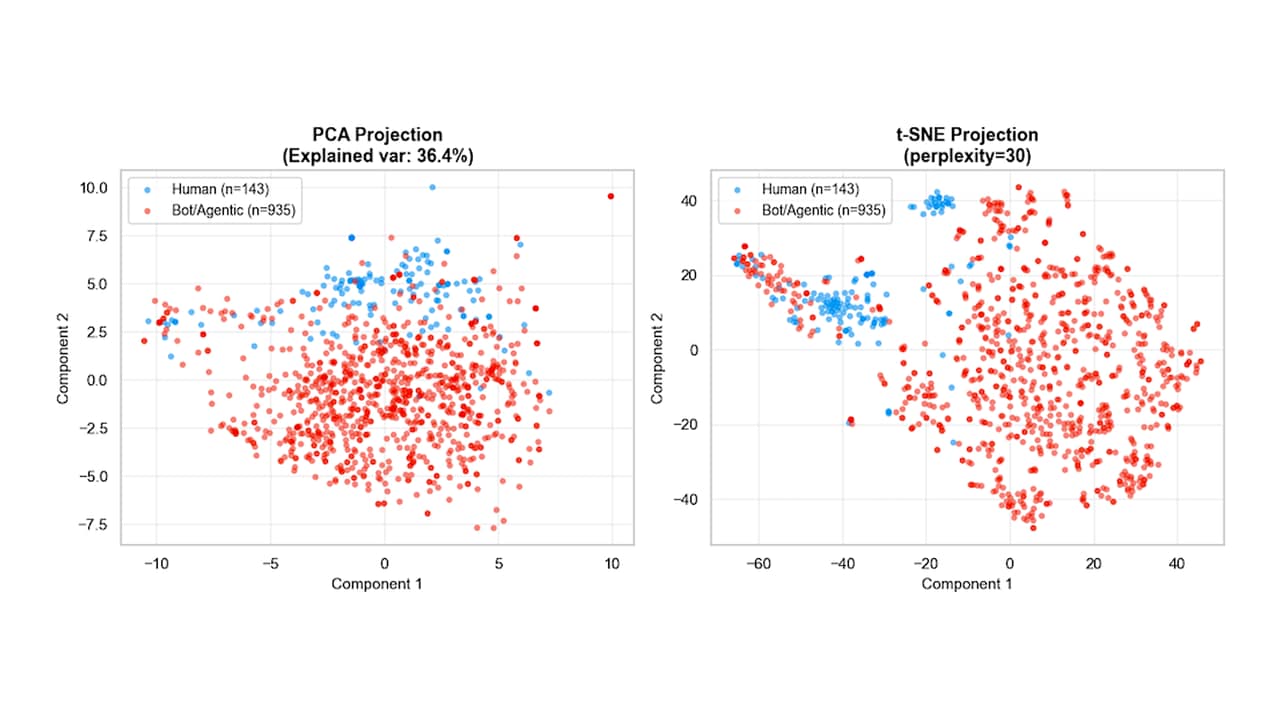
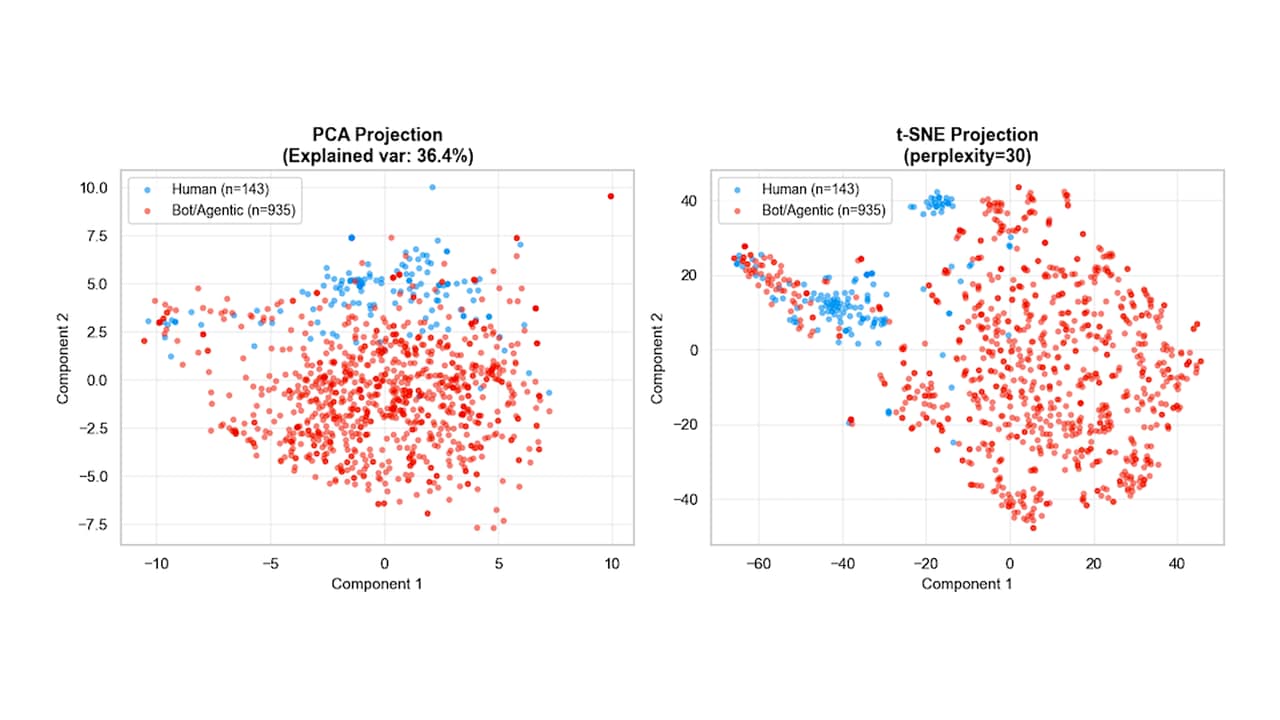
Lorsqu'elles sont projetées dans un espace à deux dimensions, les représentations apprises par le modèle transformeur montrent une séparation relativement nette entre les comportements humains et agentiques (voir la figure). Les approches très simples, telles que l'utilisation d'une frontière de décision hyperplane avec un SVM, se sont révélées peu efficaces. En revanche, un réseau MLP peu profond parvient à distinguer les différentes classes et à généraliser de manière satisfaisante, malgré un volume limité de données d'entraînement étiquetées.

Représentations projetées depuis l'espace d'origine à 64 dimensions vers un espace bidimensionnel à l'aide de l'analyse en composantes principales (ACP) et de l'algorithme t-SNE

Et la suite ?

Les outils de navigation basés sur l'IA agentique marquent le début d'une nouvelle ère du trafic Web, dans laquelle les sessions peuvent mêler télémétrie humaine et télémétrie artificielle, et à laquelle les modèles de détection existants n'ont pas été préparés. 

L'architecture décrite dans cet article nous offre une méthode structurée pour analyser même les séquences de mouvements de souris les plus réduites : un transformeur auto-supervisé qui apprend la structure des comportements à partir de millions de séquences non étiquetées, suivi d'un classificateur léger entraîné sur un ensemble soigneusement constitué de sessions agentiques étiquetées.

Dans le deuxième volet de cette série, nous mettrons ce modèle à l'épreuve. Nous présenterons des mesures de détection au niveau des requêtes et des sessions, montrerons dans quelle mesure les signatures comportementales se généralisent à différents sites clients et visualiserons les différences entre les sessions agentiques et les sessions humaines. Nous aborderons également la notion de précision opérationnelle, ce qu'elle signifie dans le cadre d'un déploiement réel et quelles conditions doivent être réunies pour transformer cette preuve de concept en une capacité prête pour la production.

Les travaux de recherche présentés dans cet article ont été menés par les équipes Akamai Threat Research et Data Science. L'ensemble de données agentiques étiquetées a été collecté puis anonymisé conformément à un protocole standardisé, à partir de sites clients sur lesquels Bot Manager Premier était déployé.

À propos de l'auteur

Michael Sparkman image

Michael Sparkman

Michael Sparkman is a Data Scientist at Akamai. He has 6 years experience working on disaster and relief projects and fraud and security analytics with a focus on bot automation. At Akamai, he researches new automation threats and works with customers to keep their security postures strong.

Daniel Estevan McAndrew

Daniel McAndrew

Daniel Estevan McAndrew is a Senior Data Scientist at Akamai, where he has spent five years developing machine-learning models for bot detection and abuse prevention. His work spans behavioral telemetry analysis and large-scale anomaly detection across Akamai Bot & Agent Control products. Before joining Akamai, he worked at Intel as a Software Engineer in Computer Vision for live sports broadcasting. He lives in Oakland, California, where he can usually be found hiking with his partner and two huskies.