Pular para o conteúdo principal
Background

Identificando a automação proativa por meio da telemetria comportamental

August 19, 2026 by Michael Sparkman e Daniel McAndrew

Compartilhar

Principais conclusões

Agentes de navegação autônomos baseados em IA criam uma nova categoria de tráfego na web, que opera com telemetria comportamental escassa e altamente eficiente em termos de recursos.

Os modelos tradicionais de detecção de bots não conseguem avaliar esses agentes, pois mais de 98% de suas solicitações contêm pouco ou nenhum movimento do mouse.

A Akamai desenvolveu um modelo de prova de conceito baseado em um transformador baseado em autocodificador com máscara, que trata os dados de telemetria do mouse como tokens de linguagem para analisar sequências curtas de eventos.

Um classificador leve, treinado com incorporações de transformadores, consegue distinguir com sucesso a automação baseada em agentes das interações humanas esporádicas, alcançando alta precisão mesmo diante de um desequilíbrio extremo entre as classes.
 

Um novo tipo de visitante está navegando no seu site, e ele não move o mouse da forma que você esperaria. No último ano, surgiu uma nova categoria de ferramentas de inteligência artificial que vai além de simplesmente responder a perguntas: Ela assume o controle do seu navegador e passa a agir.

Ferramentas como Perplexity Comet, OpenAI Atlas e a extensão do Claude para o Chrome permitem que você faça solicitações em linguagem natural, como "Encontre um voo para Boston por menos de 300 dólares e faça a reserva". Em seguida, ele pode navegar pela internet de forma autônoma para concluir a tarefa. Não há mãos humanas no mouse nem alguém lendo a página – apenas um agente de inteligência artificial, que navega pelo seu site clicando e digitando como se fosse uma pessoa.

Essa automação também é conhecida como modo "navegador de controle" e gera um tipo de tráfego na web que não se enquadra nem como tráfego de bots tradicional nem como tráfego humano. Na Akamai, queríamos entender como esse tráfego se apresenta em termos de telemetria e se seria possível identificá-lo.

O trabalho descrito neste artigo do blog — a primeira parte de uma série de duas — é um projeto de pesquisa de prova de conceito (PoC), e nossa intenção é transformá-lo, no futuro, em uma solução mais robusta e pronta para uso em produção.

Observação: A OpenAI anunciou o fim do projeto Atlas após a conclusão da nossa pesquisa. Apesar dessa mudança, nossa pesquisa oferece insights valiosos sobre como os agentes de IA podem controlar e navegar em navegadores.

Uma terceira categoria de tráfego

Há anos, a segurança na web tem sido baseada em um modelo binário de detecção de bots: Uma solicitação pode ser feita por um humano ou por um bot. Os bots dividem-se em duas categorias: a primeira é composta por crawlers simples e pouco sofisticados, que não tentam se passar por humanos; e a segunda é formada por imitadores sofisticados, que geram movimentos de mouse sintéticos, variam o tempo de resposta e tentam parecer humanos.

Agentes em modo de automação não se enquadram em nenhuma das categorias de bots. Eles não estão tentando enganar ninguém; simplesmente não funcionam da mesma forma que um humano. Quando um agente acessa uma página da web, ele vai diretamente ao seu destino.

  • Ele não move o cursor aleatoriamente durante a leitura.

  • Não passa o cursor sobre o elemento antes de clicar. 

  • Não rola a tela para explorar.

  • Ele clica com precisão, digita com eficiência e segue em frente.

O resultado é uma assinatura comportamental caracterizada por poucos sinais, movimentos mecânicos e uso eficiente de recursos. E isso gera um problema de detecção que as ferramentas atuais não foram projetadas para resolver.

Por que nossos modelos comportamentais atuais falharam?

O Akamai Bot Manager Premier coleta telemetria comportamental detalhada, como sequências de eventos do mouse (movimentos, cliques e rolagens), que são transmitidos a partir de todas as páginas da web monitoradas. Nossos modelos comportamentais atuais analisam essas sequências para distinguir humanos de bots. Eles são bons nisso. Mas têm uma exigência inegociável: precisam de uma quantidade suficiente de eventos em uma sequência para realizar uma comparação significativa.

Aqui está o que descobrimos ao aplicar esses modelos a centenas de sessões coletadas do Comet e do Atlas, ambos operando em modo automático:

  • 63,2% das solicitações de autopublicação automatizadas não registraram nenhum evento de mouse.

  • 35,8% dos eventos registrados apresentaram contagens abaixo do limite mínimo.

  • Apenas 1,0% das solicitações apresentaram movimento suficiente para serem avaliadas.

O modelo atual de detecção de movimentos do mouse identificou menos de 1% de todas as solicitações realizadas por agentes como suspeitas. Os modelos não estavam falhando; simplesmente nunca puderam ser executados. Agentes em modo de automação não geram dados de telemetria do mouse, pois geralmente não utilizam esse dispositivo. Eles navegam de forma programática. A telemetria é escassa, não porque o agente está tentando evitar a detecção, mas porque ele simplesmente não gera artefatos de interação semelhantes aos humanos.

A principal questão a ser resolvida era a diferença entre "avaliado" e "avaliável".

Repensando o problema: eventos do mouse como linguagem

Para criar um modelo que funcione com dados de telemetria escassos, foi necessário mudar a nossa abordagem.

Pense nos eventos do mouse da mesma forma que pensa nas palavras. Uma única palavra não revela quase nada sobre quem escreveu uma frase. Mas os padrões nas palavras, incluindo seu ritmo, frequência relativa e pausas, podem revelar muito sobre elas. Uma frase escrita por um agente é concisa e objetiva; não há divagações, retrocessos ou palavras desnecessárias. Uma frase escrita por um ser humano é mais caótica e mais rica.

Essa analogia norteou a nossa abordagem de modelagem. E essa analogia não é apenas metafórica, mas também arquitetônica. Nossa experiência em ajustar modelos de linguagem grandes (LLMs) nos levou a identificar um paralelo direto: Os mesmos mecanismos de atenção que permitem aos transformadores modelar relações entre palavras em uma frase podem ser aplicados para modelar relações entre eventos de mouse em uma sequência comportamental. 

Nos blocos de atenção de chave e consulta de um transformador, cada token interage com todos os outros tokens, permitindo que o modelo aprenda quais são mais relevantes para o significado de outro, independentemente da distância entre eles. Quando aplicado à telemetria de mouse, isso significa que um modelo pode aprender a relação entre um pequeno número de eventos. Além disso, descobrimos que esses modelos de transformadores são capazes de aprender a explorar essas relações de forma eficaz, mesmo quando as sequências são curtas.

Em vez de desenvolver um modelo que precisasse analisar uma longa sequência de eventos, treinamos um modelo para compreender o significado de sequências curtas, permitindo distinguir o repertório limitado e intencional de movimentos do mouse de um agente automatizado daquele de um ser humano.

Nossa arquitetura de detecção em duas etapas

A arquitetura a seguir representa um design de prova de conceito. A escala dos dados de treinamento e da capacidade do modelo é intencionalmente modesta para uma investigação inicial; a implementação em produção exigiria modelos maiores e uma coleta de dados rotulados mais abrangente.

Estágio 1: Aprendendo a identificar o comportamento do mouse

Antes de classificar as sessões como automatizadas ou humanas, precisávamos primeiro ensinar ao nosso modelo a estrutura subjacente do comportamento normal de um mouse.

Adaptamos um transformador baseado em um autocodificador com máscara, uma arquitetura de processamento de linguagem natural auto-supervisionada, para aplicação em telemetria comportamental. O modelo foi treinado com base em aproximadamente 3,5 milhões de sequências de eventos de mouse não rotuladas, obtidas a partir de dados reais do Bot Manager Premier. Durante o treinamento, 35% dos eventos em cada sequência foram mascarados aleatoriamente para que o modelo pudesse reconstruí-los com base no contexto, sem a necessidade de rótulos manuais.

Arquitetura leve

A arquitetura é leve por padrão: 

  • 44.000 parâmetros

  • 3 camadas de transformadores

  • 4 cabeças de atenção

  • Incorporação fixa de 64 dimensões por sequência

Codificando o tempo em vez da posição

Uma decisão crucial de design foi a substituição das codificações posicionais padrão (como "1º evento", "2º evento") por carimbos de data/hora cumulativos.  Aplicar a codificação senoidal ao tempo decorrido equivale a uma decomposição de Fourier, projetando cada carimbo de data/hora em múltiplas frequências simultaneamente.

  • Componentes de alta frequência captam microintervalos entre eventos rápidos.

  • Os componentes de baixa frequência captam o ritmo geral da sessão.

Isso obriga o modelo a aprender padrões de tempo como uma característica essencial. As pausas longas e irregulares, típicas dos agentes de inteligência artificial (às vezes com vários segundos entre os cliques), passam a ser um sinal significativo, em vez de um artefato relacionado ao comprimento da sequência.

Estágio 2: Aprender a identificar agentes

Utilizando um modelo transformador pré-treinado que gera incorporações comportamentais de 64 dimensões, treinamos um classificador supervisionado compacto para identificar comportamentos proativos. Para isso, coletamos 2.190 sequências rotuladas como proativas, executando o Comet, o Atlas e a extensão do Claude para o Chrome em sites reais de clientes equipados com o Bot Manager Premier.

Nossa equipe utilizou essas ferramentas seguindo instruções padronizadas:

  • “Acesse a página do produto e adicione o item X ao carrinho.” 

  • “Encontre a página de login.” 

  • “Compare os itens da categoria Y.” 

Em seguida, coletamos as sessões geradas pelo Bot Manager Premier. Os dados básicos humanos foram extraídos das mesmas propriedades do cliente.

A combinação desses fatores gerou um desequilíbrio significativo entre as classes: aproximadamente 85 sessões humanas para cada sessão realizada por um agente. Para resolver esse problema, utilizamos funções de perda ponderadas por classe e uma ampla técnica de aumento de dados na classe minoritária, que incluía ruído gaussiano, eliminação aleatória de características e escalonamento temporal aleatório.

O classificador de segunda etapa é um perceptron multicamadas simples (MLP), com duas camadas ocultas (64 → 32 unidades) sobrepostas a um embedding de 64 dimensões. Comparamos essa abordagem com uma máquina de vetores de suporte (SVM) de classe única, o algoritmo Isolation Forest e uma abordagem baseada em autocodificador variacional (VAE) (tabela). A rede MLP supervisionada superou significativamente todas as alternativas, inclusive os métodos de classe única, que geralmente são considerados mais eficazes para generalizar dados não vistos anteriormente.


AbordagemROC-AUCPR-AUCNotas
SVM de uma classe0,7970,044Treinado exclusivamente com dados humanos
Isolation Forest0,8330,038Taxa de recall quase nula em limites úteis
VAE + perda baseada em energia0,8820,410Promissor, mas difícil de ajustar
MLP de baixa profundidade (final)0,9810,661Abordagem selecionada

Comparação de modelos de classificação em segunda etapa que demonstra o melhor desempenho da MLP de baixa profundidade.

Principais informações

O comportamento proativo não está simplesmente fora do padrão humano; ele se sobrepõe parcialmente a interações humanas esporádicas, como as de usuários que clicam uma vez diretamente e depois saem. Detectar agentes exige aprender um limite discriminativo, e não apenas identificar valores atípicos.

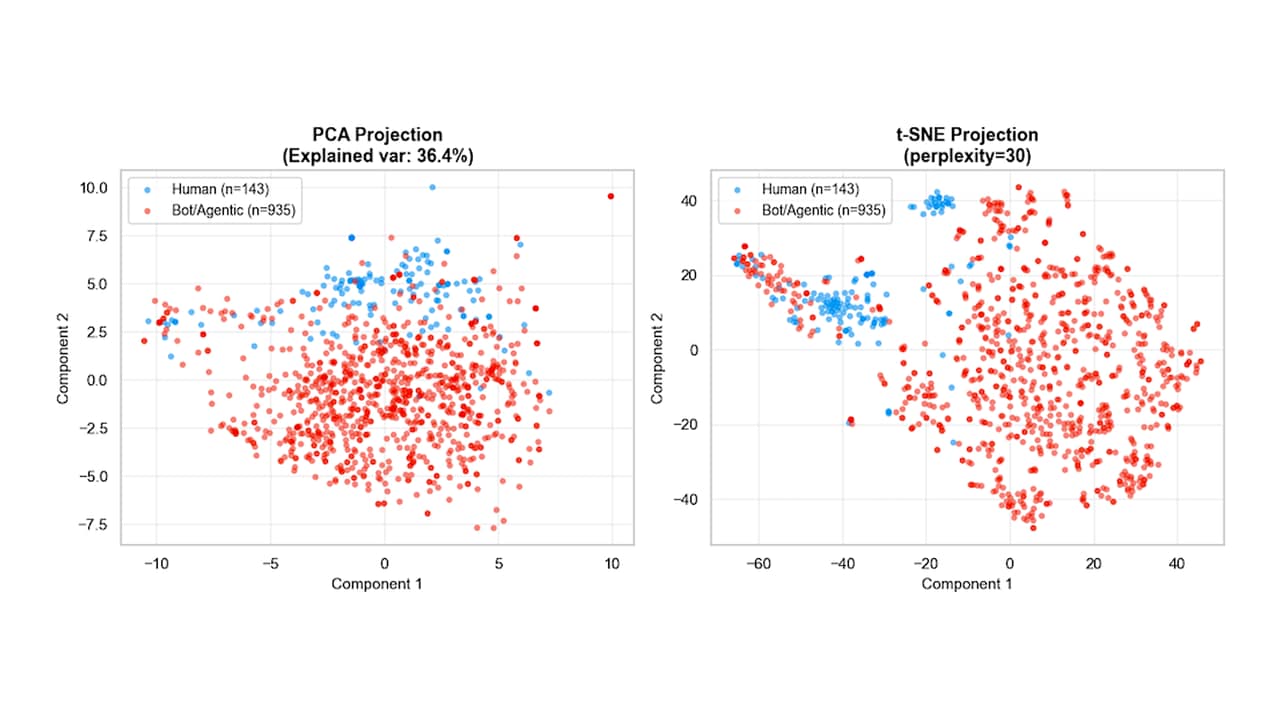
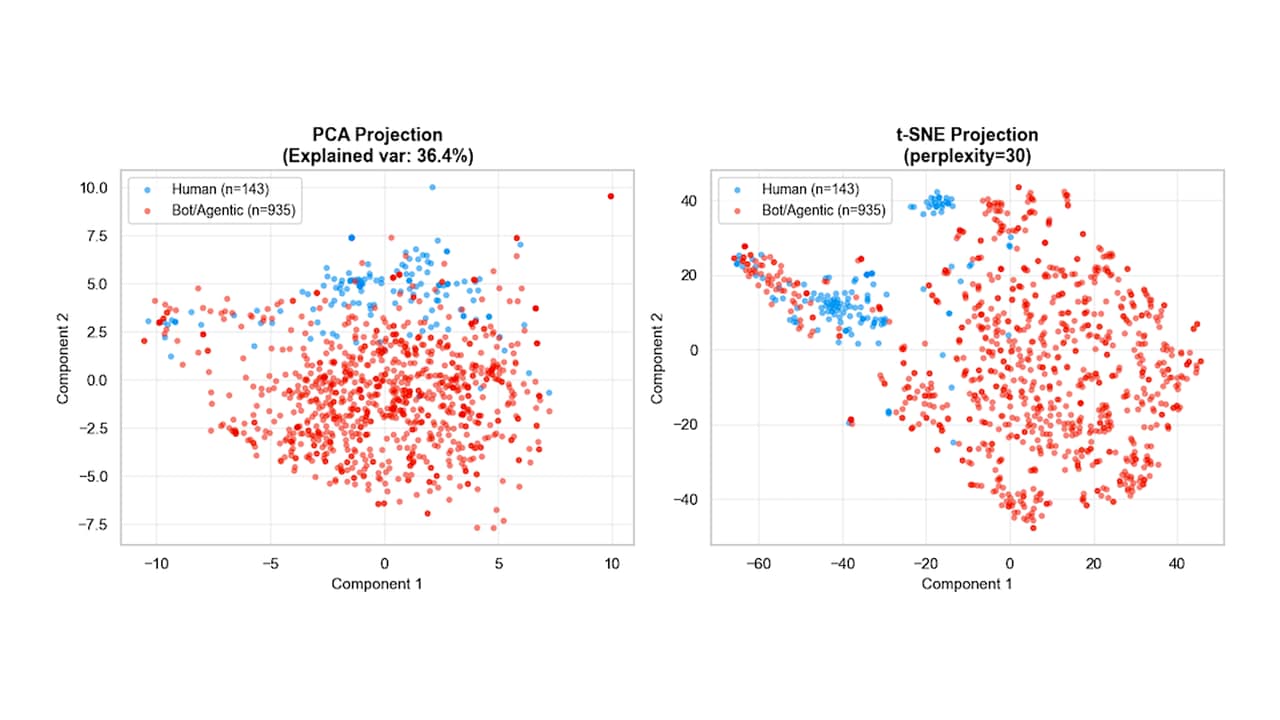
Quando projetadas em um espaço bidimensional, é possível observar uma separação relativamente clara entre as incorporações humanas e as incorporações relacionadas a agentes, aprendidas pelo modelo de transformador (Figura). Abordagens muito simples, como o uso de um hiperplano como fronteira de decisão em uma SVM, não apresentaram resultados satisfatórios. No entanto, uma rede de perceptron multicamadas (MLP) de baixa profundidade consegue aprender a distinguir as diferentes classes e apresentar uma capacidade de generalização razoável, mesmo com uma quantidade limitada de dados de treinamento rotulados.

Projeção de incorporações do espaço original de 64 dimensões para um espaço bidimensional, utilizando análise de componentes principais (PCA) e incorporação de vizinhos estocásticos distribuída em t (t-SNE).

O que vem depois

As ferramentas de navegação baseadas em IA autônoma estão inaugurando uma nova era no tráfego na web, na qual as sessões podem combinar dados de telemetria humana e artificial, algo que os modelos de detecção atuais não foram projetados para identificar. 

A arquitetura descrita neste artigo nos oferece uma maneira estruturada de analisar até mesmo as sequências de movimentos do mouse mais esparsas: um transformador de autoaprendizagem que aprende a estrutura comportamental a partir de milhões de sequências não rotuladas, seguido por um classificador leve treinado em um conjunto cuidadosamente selecionado de sessões rotuladas de agentes.

Na segunda parte desta série, vamos colocar o modelo à prova. Vamos compartilhar métricas de detecção em nível de solicitação e de sessão, demonstrar como as assinaturas comportamentais se aplicam a diferentes sites de clientes e mostrar como as sessões automatizadas se comparam às sessões humanas. Além disso, vamos discutir o que significa a precisão operacional em uma implementação prática e quais são os passos necessários para desenvolver uma capacidade pronta para produção.

A pesquisa descrita neste artigo foi realizada pelas equipes de Pesquisa de Ameaças e Ciência de Dados da Akamai. O conjunto de dados rotulados de agentes de IA foi coletado e anonimizado seguindo um protocolo padronizado, por meio de sites de clientes instrumentados com o BMP.

Sobre o autor

Michael Sparkman image

Michael Sparkman

Michael Sparkman is a Data Scientist at Akamai. He has 6 years experience working on disaster and relief projects and fraud and security analytics with a focus on bot automation. At Akamai, he researches new automation threats and works with customers to keep their security postures strong.

Daniel Estevan McAndrew

Daniel McAndrew

Daniel Estevan McAndrew is a Senior Data Scientist at Akamai, where he has spent five years developing machine-learning models for bot detection and abuse prevention. His work spans behavioral telemetry analysis and large-scale anomaly detection across Akamai Bot & Agent Control products. Before joining Akamai, he worked at Intel as a Software Engineer in Computer Vision for live sports broadcasting. He lives in Oakland, California, where he can usually be found hiking with his partner and two huskies.